Представлен VFlash: роботы планируют траектории за один проход, ~25x быстрее
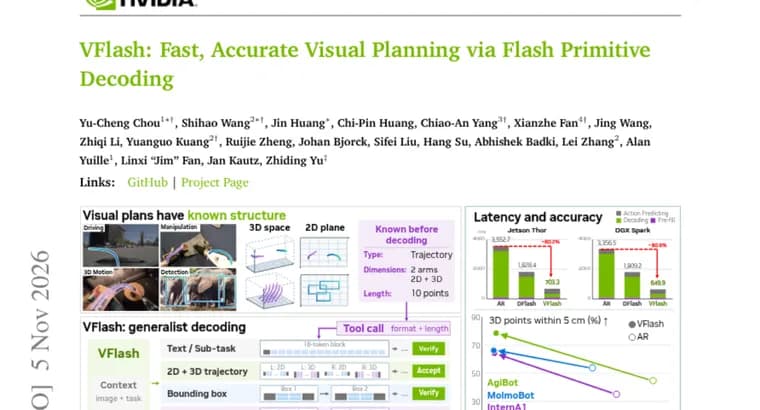
Модели для физического ИИ, робототехники и автономного вождения, могут рассуждать не только словами. Они способны строить визуальные планы: точки, ограничивающие рамки (bounding boxes) и траектории, которые описывают пространственные цели и предсказывают движение. Проблема в том, что авторегрессионные визуально-языковые модели порождают такие планы по одному координатному токену за раз, поэтому более богатые предсказания обходятся всё дороже.
В статье представлен метод VFlash и подход Flash Primitive Decoding (быстрое декодирование примитивов). Он использует известную структуру визуальных примитивов и предсказывает их координаты совместно: облегчённый генератор-черновик (drafter) выдаёт весь примитив за один прямой проход. Его раскладка подстраивается под тип примитива, размерность и длину, поэтому метод подходит и для компактных рамок, и для длинных траекторий переменной длины.
Ключевая идея: пространственная точность не требует воспроизводить точную последовательность токенов авторегрессионной модели. Поэтому VFlash обучается на размеченных примитивах и напрямую принимает структурно корректные предсказания, не добиваясь совпадения с целевыми токенами.
Результаты по заявлению авторов статьи: на проверенных задачах 2D- и 3D-траекторий роботов VFlash последовательно снижает ошибки предсказания по сравнению с авторегрессионным декодированием (числовые значения снижения не приведены). Предварительные измерения на одном прогоне показывают примерно 25-кратное ускорение генерации для прогноза движения 3D-точек. Мировая модель действий (world action model), опирающаяся на планы VFlash, достигает 70,2% средней успешности на четырёх наборах задач MolmoSpaces против 62,6% у базового варианта.
Ключевые факты
- VFlash предсказывает все координаты визуального примитива (точки, рамки, траектории) за один прямой проход облегчённого генератора вместо поштучной генерации токенов.
- Обучение идёт на размеченных примитивах; структурно корректные предсказания принимаются без совпадения с токенами целевой модели.
- Предварительные измерения на одном прогоне: примерно 25-кратное ускорение прогноза движения 3D-точек.
- На задачах 2D- и 3D-траекторий роботов метод последовательно снижает ошибки предсказания относительно авторегрессионного декодирования.
- Мировая модель действий с планами VFlash: 70,2% средней успешности на четырёх наборах MolmoSpaces против 62,6% у базового варианта.
Почему это важно
Визуальные планы вроде траекторий и рамок нужны роботам и системам автономного вождения, но при поштучной генерации координат длинные и подробные планы становятся дорогими по времени. VFlash предлагает отказаться от пошаговой генерации и выдавать примитив целиком, что в заявленном примере даёт примерно 25-кратное ускорение прогноза движения 3D-точек.
Кому это важно
Исследователям и инженерам в области робототехники и физического ИИ, которые используют визуально-языковые модели для планирования движений, а также тем, кого интересует ускорение вывода в задачах со структурированными выходными данными.
Как это применить
Это научная статья с описанием метода. Сведений о публикации кода, размере модели, обучающих данных и оборудовании в тексте нет, поэтому практическое применение пока остаётся вопросом будущих проверок. Идея для практиков: если выход модели имеет известную структуру, его можно предсказывать целиком, а не токен за токеном.
Можно ли доверять
Результаты приведены только в аннотации статьи. Само 25-кратное ускорение названо предварительным, получено на одиночных прогонах и заявлено только для прогноза движения 3D-точек. Снижение ошибок описано без цифр. Для сравнения в MolmoSpaces приведено только среднее по четырём наборам задач, а базовый вариант и мировая модель действий не названы. Независимых подтверждений в тексте нет.
Риски и подводные камни
Ускорение нельзя переносить на другие типы примитивов и задачи: цифры для 2D-задач и рамок не приведены. Рост средней успешности с 62,6% до 70,2% получен на четырёх наборах задач без разбивки по каждому, так что устойчивость результата неясна. Метод опирается на известную структуру примитивов и принимает структурно корректные предсказания без сверки с токенами авторегрессионной модели, поэтому за пределами таких структурированных выходов его применимость не показана.