Представлен SO-101 Bench: бенчмарк для недорогой роборуки
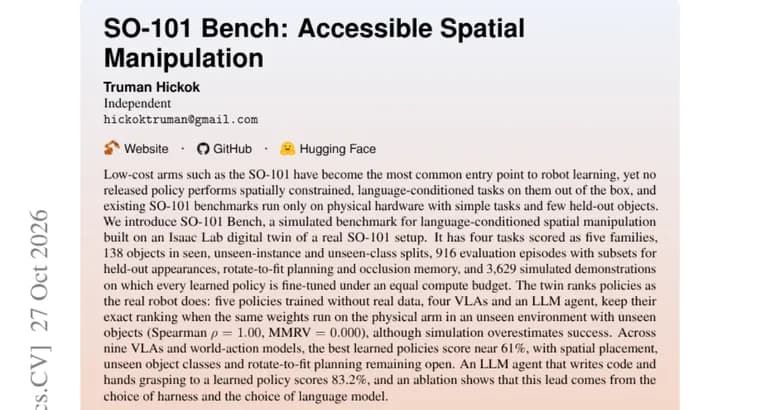
Авторы препринта отмечают, что недорогие роботизированные руки вроде SO-101 стали самой массовой точкой входа в обучение роботов. При этом ни одна опубликованная политика (модель управления) не справляется «из коробки» с пространственно ограниченными задачами по языковой команде, а существующие бенчмарки для SO-101 работают только на физическом оборудовании, с простыми задачами и малым числом объектов, не встречавшихся при обучении.
В ответ предложен SO-101 Bench, симуляторный бенчмарк для манипуляции с пространственными условиями по языковой инструкции. Он построен на цифровом двойнике реальной установки с SO-101 в среде Isaac Lab. В бенчмарке четыре задачи, оцениваемые по пяти семействам метрик, 138 объектов, разделённых на выборки seen (знакомые), unseen-instance (новые экземпляры) и unseen-class (новые классы), 916 эпизодов оценки с подмножествами для новых внешних видов объектов, планирования «повернуть, чтобы поместилось» и памяти при перекрытии объекта, а также 3629 симулированных демонстраций. На них дообучается каждая обучаемая политика, причём при одинаковом вычислительном бюджете.
Главная проверка достоверности, перенос на реального робота. Пять политик, обученных без реальных данных (четыре VLA, модели «зрение, язык, действие», и один LLM-агент), сохранили точно такой же порядок в рейтинге, когда те же веса запустили на физической руке в незнакомой обстановке с незнакомыми объектами: корреляция Спирмена rho = 1,00, MMRV = 0,000. Оговорка авторов: симуляция завышает успешность по сравнению с реальностью.
На девяти VLA и моделях типа world-action лучшие обученные политики набирают около 61%. Нерешёнными остаются пространственное размещение, незнакомые классы объектов и планирование «повернуть, чтобы поместилось». LLM-агент, который пишет код и отдаёт захват обученной политике, показывает 83,2%. Абляция (отключение компонентов по одному) показывает, что это преимущество обеспечивают выбор оболочки агента (harness) и выбор языковой модели.
Ключевые факты
- SO-101 Bench, симуляторный бенчмарк на цифровом двойнике реальной установки с недорогой рукой SO-101 в Isaac Lab: четыре задачи, пять семейств метрик, 138 объектов, 916 эпизодов оценки.
- Каждая обучаемая политика дообучается на 3629 симулированных демонстрациях при равном вычислительном бюджете.
- Рейтинг пяти политик (четыре VLA и LLM-агент) в симуляции и на реальной руке совпал полностью: Spearman rho = 1,00, MMRV = 0,000; при этом симуляция завышает успешность.
- Лучшие обученные политики среди девяти VLA и моделей world-action набирают около 61%; слабые места, пространственное размещение, новые классы объектов и планирование «повернуть, чтобы поместилось».
- LLM-агент, пишущий код и передающий захват обученной политике, получает 83,2%; по абляции, преимущество даёт выбор оболочки агента и языковой модели.
Почему это важно
Недорогие руки вроде SO-101, самый частый вход в обучение роботов, но, по словам авторов, готовой политики для пространственных задач по языковой команде для них нет, а прежние бенчмарки требовали физического железа. Симуляторный набор тестов с проверкой переноса на реальную руку позволяет сравнивать подходы без дорогих экспериментов. Заметен и содержательный результат: агент, который пишет код и делегирует захват обученной политике, обошёл чисто обученные политики (83,2% против примерно 61%).
Кому это важно
Исследователям и энтузиастам робототехники, работающим с SO-101 или похожими недорогими манипуляторами; авторам VLA-моделей и моделей world-action, которым нужен единый тест на пространственное размещение, новые классы объектов и память при перекрытии; тем, кто строит агентов на основе языковых моделей для управления роботами.
Как это применить
Бенчмарк предназначен для сравнения политик: обучить на предложенных 3629 демонстрациях при равном вычислительном бюджете и оценить на 916 эпизодах с разделением на знакомые, новые экземпляры и новые классы объектов. В источнике не упоминаются публикация кода, набора данных и лицензия, поэтому доступность придётся уточнять в самой статье.
Можно ли доверять
Это препринт; результаты приведены самими авторами. В тексте не названы авторы и организации, не перечислены девять оценённых моделей и не указано, какие языковая модель и оболочка стоят за агентом с 83,2%. Подтверждение переноса опирается на пять политик: идеальное совпадение рангов на такой малой выборке, аргумент в пользу симулятора, но не исчерпывающее доказательство. Цифра «около 61%» дана приблизительно, и не уточнено, среднее это значение или результат лучшей модели.
Риски и подводные камни
Симуляция завышает успешность по сравнению с реальной рукой; насколько именно, в источнике не сказано, как и не приведены результаты на реальном роботе. Совпадение рангов проверено в одной незнакомой обстановке и на ограниченном наборе политик. Сравнение агента с обученными политиками зависит от выбора оболочки и языковой модели: авторы сами показывают, что именно они дают преимущество, так что результат нельзя считать свойством подхода «агент с кодом» в целом.