Предложен Soft-MTP: правка в одну строку улучшает обучение MTP
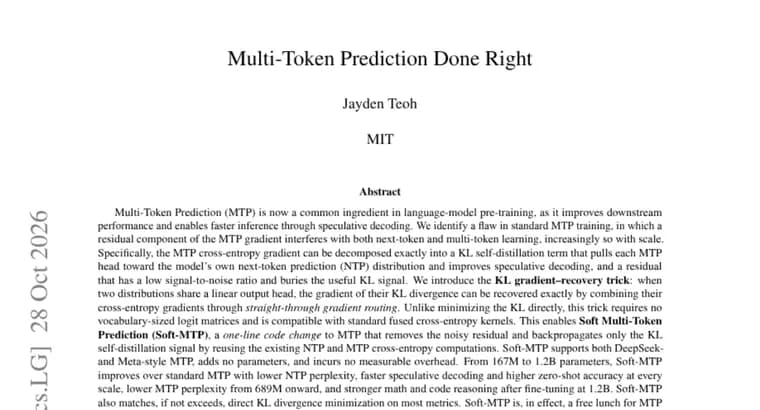
Предсказание нескольких токенов (Multi-Token Prediction, MTP) стало распространённой частью предобучения языковых моделей: оно улучшает качество на downstream-задачах (прикладных задачах после обучения) и ускоряет вывод за счёт спекулятивного декодирования. Авторы препринта утверждают, что у стандартного обучения MTP есть изъян: остаточная составляющая градиента мешает и обучению предсказанию следующего токена, и обучению предсказанию нескольких токенов, причём чем больше модель, тем сильнее.
По их разбору, градиент кросс-энтропии MTP точно раскладывается на две части. Первая, член KL-самодистилляции: он подтягивает каждую MTP-голову к распределению самой модели по следующему токену (NTP) и улучшает спекулятивное декодирование. Вторая, остаток с низким отношением сигнал/шум, который заглушает полезный KL-сигнал.
Чтобы убрать остаток, авторы вводят «приём восстановления KL-градиента»: если два распределения используют общую линейную выходную голову, градиент их KL-дивергенции можно точно восстановить, скомбинировав градиенты их кросс-энтропий через сквозную маршрутизацию градиента (straight-through gradient routing). В отличие от прямой минимизации KL, такой приём не требует матриц логитов размером со словарь и совместим со стандартными объединёнными (fused) ядрами кросс-энтропии.
На этом основан Soft Multi-Token Prediction (Soft-MTP), правка MTP в одну строку кода. Она убирает шумный остаток и пропускает назад только сигнал KL-самодистилляции, повторно используя уже посчитанные кросс-энтропии NTP и MTP. Soft-MTP работает с MTP в стиле DeepSeek и в стиле Meta, не добавляет параметров и, по заявлению авторов, не даёт измеримых накладных расходов.
Результаты: на моделях от 167 млн до 1,2 млрд параметров Soft-MTP по сравнению со стандартным MTP даёт на каждом масштабе более низкую перплексию NTP, более быстрое спекулятивное декодирование и более высокую точность zero-shot (без дообучения на задаче). Более низкая перплексия MTP отмечена начиная с 689 млн параметров, а более сильные рассуждения в математике и коде после дообучения, на 1,2 млрд. Кроме того, Soft-MTP на большинстве метрик не уступает прямой минимизации KL-дивергенции, а то и превосходит её. Сами авторы называют Soft-MTP «бесплатным обедом» для оптимизации MTP. Код опубликован на GitHub.
Ключевые факты
- Градиент кросс-энтропии MTP точно раскладывается на полезный член KL-самодистилляции и шумный остаток с низким отношением сигнал/шум; остаток, по мнению авторов, мешает обучению всё сильнее с ростом масштаба.
- Soft-MTP, правка в одну строку кода: остаётся только KL-сигнал, а уже вычисленные кросс-энтропии NTP и MTP используются повторно.
- Метод подходит для MTP в стиле DeepSeek и Meta, не добавляет параметров и, по заявлению авторов, не даёт измеримых накладных расходов.
- На моделях от 167 млн до 1,2 млрд параметров: ниже перплексия NTP, быстрее спекулятивное декодирование, выше точность zero-shot на каждом масштабе; перплексия MTP ниже начиная с 689 млн.
- На 1,2 млрд параметров после дообучения сообщается об улучшении в рассуждениях по математике и коду; на большинстве метрик метод не хуже прямой минимизации KL.
Почему это важно
MTP уже стал обычным ингредиентом предобучения языковых моделей, а значит, даже небольшая поправка к его градиенту потенциально затрагивает много обучающих запусков. Авторы показывают, что у стандартной схемы есть конкретная и измеримая проблема, шумная остаточная часть градиента, и предлагают лечить её не новой архитектурой, а правкой в одну строку. Ценность работы в том, что решение дёшево: без новых параметров и без заметных накладных расходов.
Кому это важно
Командам, которые предобучают собственные языковые модели с MTP-головами (в стиле DeepSeek или Meta), и исследователям, занимающимся спекулятивным декодированием: именно его скорость, по данным авторов, растёт. Интересна работа и тем, кто пишет обучающий код: приём совместим со стандартными объединёнными ядрами кросс-энтропии и не требует матриц логитов размером со словарь.
Как это применить
Авторы опубликовали код на GitHub (репозиторий Soft-MTP). Суть внедрения, заменить расчёт MTP-потерь так, чтобы назад шёл только сигнал KL-самодистилляции, повторно используя уже посчитанные кросс-энтропии NTP и MTP. Метод заявлен как совместимый с обоими вариантами MTP, DeepSeek и Meta. Перед переносом на свой запуск разумно воспроизвести результат на небольшой модели, поскольку проверка в работе доходит только до 1,2 млрд параметров.
Можно ли доверять
Это препринт с листинга Hugging Face Papers; приведён лишь текст аннотации, и все утверждения, слова самих авторов. В аннотации не названы числовые величины улучшений (значения перплексии, коэффициенты ускорения, прирост точности), не указаны бенчмарки и не упомянуты независимые воспроизведения. Заявление о «бесплатном обеде», самооценка авторов. Плюс: код открыт, так что проверить результат можно самостоятельно.
Риски и подводные камни
Результаты заявлены для моделей от 167 млн до 1,2 млрд параметров; о больших масштабах, на которых обычно обучают современные модели, ничего не сказано. Выигрыш по перплексии MTP отмечен только начиная с 689 млн параметров. Сравнение с прямой минимизацией KL, «не хуже, а то и лучше» лишь на большинстве метрик, то есть по каким-то метрикам преимущества может не быть. Величину практического эффекта по аннотации оценить нельзя.
Компания Meta Platforms признана экстремистской организацией, её деятельность на территории РФ запрещена.