Представлен iPrefBench: тест персональных ИИ-агентов для iOS, где они плохо понимают пользователя
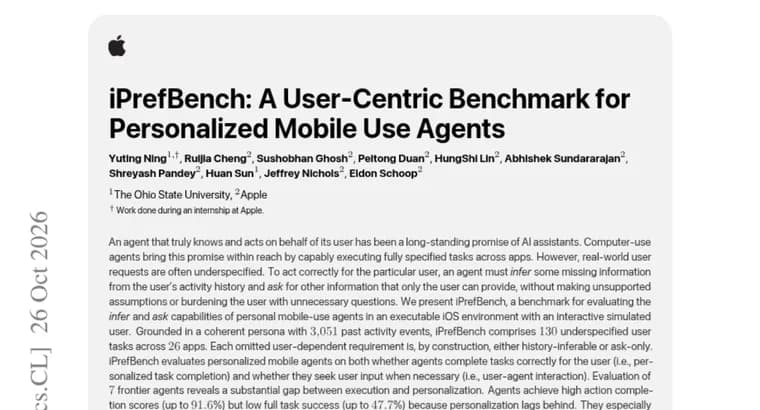
Авторы работы представили iPrefBench, бенчмарк для оценки того, как персональные агенты для смартфонов справляются с двумя навыками: выводить недостающую информацию из прошлой активности пользователя (infer) и спрашивать то, что знает только сам пользователь (ask). Исходная мысль такая: агенты, управляющие приложениями, уже неплохо выполняют полностью заданные задачи, но реальные просьбы людей обычно сформулированы неполно. Чтобы поступить правильно именно для этого человека, агент должен часть сведений восстановить из истории, а часть уточнить, не делая необоснованных допущений и не донимая лишними вопросами.
Тест работает в исполняемой среде iOS с интерактивным симулированным пользователем. В основе лежит единая персона с 3 051 событием прошлой активности. В бенчмарк входят 130 недоопределённых задач в 26 приложениях. Каждое пропущенное в задаче требование, зависящее от пользователя, по построению относится к одному из двух типов: его можно вывести из истории или о нём можно только спросить.
iPrefBench оценивает две вещи: правильно ли агент выполнил задачу именно для этого пользователя (персонализированное выполнение) и обращается ли он к пользователю за недостающими сведениями, когда это необходимо (взаимодействие агента с пользователем).
Проверка семи передовых агентов показала существенный разрыв между исполнением и персонализацией. По завершению действий агенты получают высокие оценки (до 91,6%), а полный успех задачи низкий (до 47,7%), из-за того, что персонализация отстаёт. Особенно плохо агенты справляются с информацией, о которой можно только спросить: они не запрашивают достаточно необходимых сведений. Авторы делают вывод, что для персональных агентов остаётся трудной задача понять, что нужно вывести самому, а о чём спросить. Они надеются, что iPrefBench станет полезным испытательным стендом для агентов, которые знают своего пользователя и работают вместе с ним.
Ключевые факты
- iPrefBench, бенчмарк для персональных мобильных агентов в исполняемой среде iOS с интерактивным симулированным пользователем.
- Основа: одна персона с 3 051 событием прошлой активности; 130 недоопределённых задач в 26 приложениях.
- Каждое пропущенное требование по построению либо выводимо из истории, либо доступно только через вопрос пользователю.
- У семи передовых агентов действия завершаются на уровне до 91,6%, а полный успех задачи, не выше 47,7%.
- Особенно слабое место, информация «только спросить»: агенты не запрашивают достаточно необходимых сведений.
Почему это важно
Идея «ассистента, который знает пользователя и действует от его имени» давно обещана, а агенты, работающие с приложениями, уже умеют выполнять чётко заданные задачи. Но реальные просьбы обычно неполны. iPrefBench измеряет именно этот пробел: результат показывает большой разрыв между умением выполнить действия (до 91,6%) и умением сделать это правильно для конкретного человека (полный успех до 47,7%).
Кому это важно
Разработчикам мобильных и компьютерных агентов, исследователям персонализации и тем, кто строит ассистентов поверх приложений. Работа указывает на конкретное слабое место: агенты плохо решают, что вывести из истории, а о чём спросить пользователя.
Как это применить
Бенчмарк задуман как испытательный стенд для агентов, которые знают своего пользователя и работают с ним. Его можно использовать для раздельной проверки двух навыков: вывода недостающего из истории и уместных вопросов пользователю. Конкретных сведений о выкладке кода, данных или таблицы лидеров в описании нет.
Можно ли доверять
Это описание работы с Hugging Face Papers, представленное самими авторами; независимой проверки в тексте нет. Цифры 91,6% и 47,7%, максимумы среди оценённых агентов, и из описания не видно, принадлежат ли они одному и тому же агенту. Названия семи агентов в описании не указаны.
Риски и подводные камни
Тест построен на одной симулированной персоне и на симулированном пользователе, поэтому перенос результатов на реальных людей и другие платформы требует осторожности. Выводы о слабости агентов относятся к семи проверенным агентам и к 130 задачам; разбивки результатов отдельно по типам требований в описании нет.