Представлен EvoWorld: нейросеть-«мозг» учит видеомодель понимать последствия событий
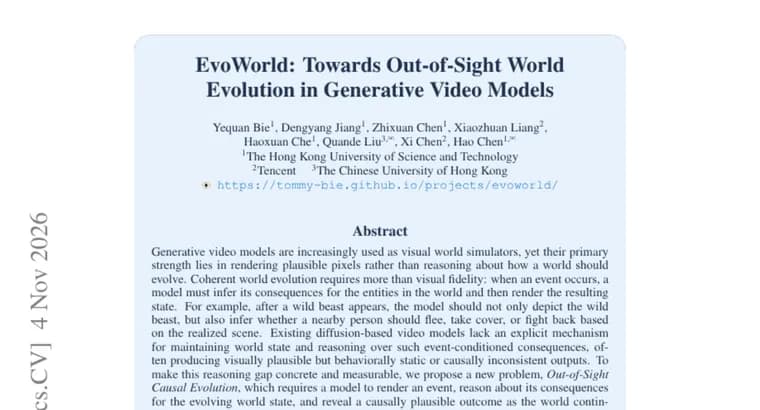
Авторы статьи отмечают, что генеративные видеомодели всё чаще используют как визуальные симуляторы мира, но их главная сила, рисовать правдоподобные пиксели, а не рассуждать о том, как мир должен меняться. Связная эволюция мира требует большего, чем визуальное качество: когда происходит событие, модель должна вывести его последствия для объектов в мире и затем показать получившееся состояние. Пример из статьи: после появления дикого зверя модель должна не просто нарисовать зверя, но и определить по уже показанной сцене, что стоит сделать находящемуся рядом человеку, убежать, укрыться или дать отпор.
По мнению авторов, у существующих видеомоделей на основе диффузии нет явного механизма для хранения состояния мира и рассуждений о последствиях событий. Поэтому результат часто выглядит правдоподобно, но поведение в кадре остаётся статичным или причинно непоследовательным.
Чтобы сделать этот пробел измеримым, авторы предлагают новую задачу, Out-of-Sight Causal Evolution (причинная эволюция вне поля зрения). Модель должна показать событие, рассудить о его последствиях для меняющегося состояния мира и раскрыть причинно правдоподобный исход, даже если мир продолжает развиваться вне поля зрения.
В качестве базового эталонного решения представлен EvoWorld, фреймворк, где «мозг» и «рендерер» работают вместе. Роль «мозга мира» играет визуально-языковая модель: она наблюдает уже сгенерированные сегменты видео, ведёт развивающееся описание мира и рассуждает о правдоподобных переходах состояния. Сегментно-авторегрессионный видеорендерер затем воплощает эти переходы визуально.
Дополнительно авторы вводят EvoWorld-Data и EvoWorld-Bench, данные для обучения и бенчмарк для оценки трёх вещей: воплощения событий, причинных реакций и согласованности при повторном возвращении в то же место (revisit consistency). По заявлению авторов, эксперименты показывают, что EvoWorld заметно улучшает причинную эволюцию, зависящую от события, по сравнению с недавними моделями, сохраняя визуальное качество и согласованность. Работа названа точкой отсчёта для управляемой рассуждением автономной эволюции мира за пределами текущего поля зрения.
Ключевые факты
- Предложена новая задача Out-of-Sight Causal Evolution: показать событие, рассудить о его последствиях и раскрыть причинно правдоподобный исход, даже когда мир развивается вне поля зрения.
- EvoWorld, базовое решение: визуально-языковая модель служит «мозгом мира» и ведёт описание состояния, а сегментно-авторегрессионный видеорендерер визуализирует переходы.
- Вместе с задачей представлены EvoWorld-Data для обучения и EvoWorld-Bench для оценки воплощения событий, причинных реакций и согласованности при возвращении.
- Авторы заявляют о существенном улучшении относительно недавних моделей при сохранении визуального качества; в тексте аннотации числовых результатов нет.
Почему это важно
Видеогенераторы всё чаще рассматривают как симуляторы мира, но, как отмечают авторы, они сильны в правдоподобной картинке, а не в причинных последствиях событий. Работа превращает этот пробел в формальную задачу с данными и бенчмарком, то есть в то, что можно измерять и сравнивать. Это шаг от «красивого видео» к видео, где мир ведёт себя последовательно.
Кому это важно
Исследователям видеогенерации и моделей мира, которым нужен способ проверять причинную связность, а не только качество кадра. Также тем, кто строит составные системы, где языковая модель управляет генератором изображений или видео.
Как это применить
Напрямую применять пока нечего: в аннотации описаны задача, фреймворк, данные и бенчмарк, но не указано, где их взять. Практически полезна сама идея разделения ролей: визуально-языковая модель хранит состояние мира и планирует переходы, а видеорендерер генерирует сегменты по очереди. Её можно использовать как схему при проектировании собственных систем и как основу для оценок по трём критериям: воплощение событий, причинные реакции, согласованность при возвращении.
Можно ли доверять
Это препринт, вся картина взята из авторской аннотации, независимой проверки нет. Утверждение об улучшении «над недавними моделями» не подкреплено числами в тексте, и не названо, с какими именно моделями шло сравнение. Пример со зверем и человеком, иллюстрация задачи, а не результат эксперимента. Судить о реальном качестве можно будет только по полному тексту статьи и опубликованным материалам.
Риски и подводные камни
Новую задачу и бенчмарк придумали те же авторы, что предлагают решение, поэтому выигрыш на их собственной оценке нужно перепроверять на независимых тестах. В аннотации не названы ни используемая визуально-языковая модель, ни видеорендерер, так что неясно, за счёт чего достигнут результат: самой схемы или сильных компонентов. Рассуждения «мозга» зависят от того, что он видит в уже сгенерированных сегментах, а значит, ошибка в состоянии мира может накапливаться по мере генерации.
«Существующим видеомоделям на основе диффузии не хватает явного механизма для поддержания состояния мира и рассуждений о таких последствиях событий.»
— Из аннотации статьи об EvoWorld