Представлен dNaViT: дискретный токенизатор изображений на замороженном энкодере
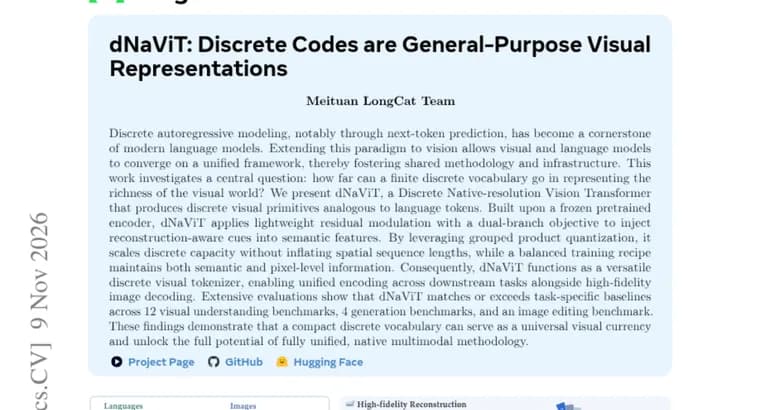
Статья, опубликованная в разделе Hugging Face Papers, исходит из того, что дискретное авторегрессионное моделирование, прежде всего предсказание следующего токена, стало основой современных языковых моделей. Если перенести этот подход на зрение, визуальные и языковые модели смогут сойтись в единой рамке и использовать общие методы и инфраструктуру. Центральный вопрос работы: насколько далеко может зайти конечный дискретный словарь в описании богатства визуального мира.
Ответ авторы предлагают в виде dNaViT (Discrete Native-resolution Vision Transformer), трансформера, работающего в «родном» разрешении изображения и выдающего дискретные визуальные примитивы, аналогичные токенам языка. Он построен на замороженном предобученном энкодере. Поверх него применяется лёгкая остаточная модуляция с двухветвевой целевой функцией: она добавляет в семантические признаки сведения, нужные для восстановления изображения.
Группированное произведение квантований (grouped product quantization) позволяет наращивать ёмкость дискретного словаря, не увеличивая длину пространственной последовательности. Сбалансированный рецепт обучения, по словам авторов, сохраняет и семантическую, и пиксельную информацию. В итоге dNaViT работает как универсальный дискретный токенизатор: он даёт единое кодирование для разных прикладных задач и при этом позволяет декодировать изображение с высокой точностью.
По утверждению авторов, в ходе обширных испытаний dNaViT соответствует специализированным базовым методам или превосходит их на 12 тестах визуального понимания, 4 тестах генерации и одном тесте редактирования изображений. Из этого они делают вывод: компактный дискретный словарь может служить «универсальной визуальной валютой» и раскрыть потенциал полностью унифицированной, «нативной» мультимодальной методологии.
Ключевые факты
- dNaViT, дискретный визуальный токенизатор: превращает изображения в дискретные примитивы, аналогичные токенам языка.
- Построен на замороженном предобученном энкодере; лёгкая остаточная модуляция с двухветвевой целью добавляет в семантические признаки информацию для восстановления изображения.
- Группированное произведение квантований увеличивает ёмкость дискретного словаря без роста длины пространственной последовательности.
- Заявлено: результат не хуже специализированных базовых методов на 12 тестах понимания, 4 тестах генерации и одном тесте редактирования изображений.
- Вывод авторов: компактный дискретный словарь может стать универсальной визуальной валютой для унифицированных мультимодальных моделей.
Почему это важно
Идея в том, чтобы описывать изображения тем же способом, каким языковые модели описывают текст, последовательностью дискретных токенов. Если это работает достаточно хорошо, понимание, генерацию и редактирование картинок можно строить на общей методологии и общей инфраструктуре с языковыми моделями. dNaViT, заявка на такой универсальный визуальный «словарь».
Кому это важно
Исследователям мультимодальных и генеративных моделей, которые занимаются визуальными токенизаторами и унификацией понимания и генерации изображений в одной авторегрессионной схеме. Практикам пока скорее как ориентир направления, чем как готовый инструмент.
Как это применить
Из аннотации не видно готового продукта для применения. Практический смысл, в самом подходе: взять замороженный предобученный энкодер, добавить квантование и получить единое дискретное кодирование для разных задач. Для оценки применимости нужно читать полный текст статьи.
Можно ли доверять
Это препринт, а все результаты в аннотации, заявления самих авторов. Приведены только количества тестов (12, 4 и один), но не названия тестов, не баллы и не отрыв от базовых методов. Не уточнено, какие базовые методы считаются специализированными; формулировка «соответствует или превосходит» не означает победы на каждом тесте. Не названы ни замороженный энкодер, ни размер словаря, ни выпуск кода или весов. Независимой проверки в источнике нет.
Риски и подводные камни
Формулировка «универсальная визуальная валюта», вывод самих авторов и пока не подтверждён внешними оценками. Дискретный словарь конечен, и именно вопрос о том, сколько визуальной информации он удерживает, предмет работы; ответ по аннотации можно оценить лишь по числу тестов, а не по конкретным цифрам. Без названий тестов и отрыва от базовых методов сложно судить, насколько сильным является результат.
«Эти результаты показывают, что компактный дискретный словарь может служить универсальной визуальной валютой и раскрыть весь потенциал полностью унифицированной, нативной мультимодальной методологии.»
— Аннотация статьи о dNaViT