Представлен бенчмарк Infrathon: Claude Opus 5.5 обошёл кодек людей в сжатии KV-кэша
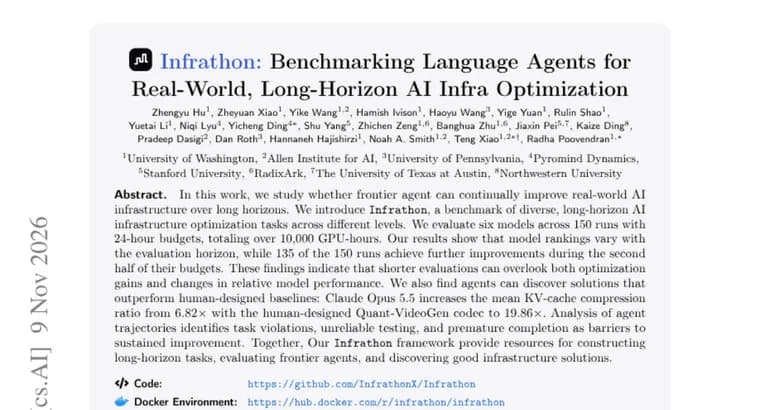
В работе исследуется, могут ли передовые ИИ-агенты непрерывно улучшать реальную инфраструктуру для ИИ на длинных временных горизонтах. Для этого авторы представили Infrathon, бенчмарк из разнообразных долгих задач по оптимизации ИИ-инфраструктуры на разных уровнях.
Авторы оценили шесть моделей в 150 запусках с бюджетом 24 часа на каждый; суммарно это более 10 000 GPU-часов. Главные результаты: рейтинг моделей меняется в зависимости от горизонта оценки, а в 135 из 150 запусков агенты добивались дальнейших улучшений во второй половине отведённого бюджета. Отсюда вывод авторов: короткие замеры могут упускать и прирост от оптимизации, и смену относительного положения моделей.
Ещё одна находка, агенты способны находить решения, превосходящие базовые варианты, созданные людьми. Пример из работы: Claude Opus 5.5 повысил среднюю степень сжатия KV-кэша (ключей и значений внимания, которые модель хранит при генерации) с 6,82% у кодека Quant-VideoGen, разработанного людьми, до 19,86%.
Анализ траекторий агентов выявил три барьера для устойчивого улучшения: нарушения условий задачи, ненадёжное тестирование и преждевременное завершение работы. Фреймворк Infrathon, по словам авторов, даёт ресурсы для построения длинных задач, оценки передовых агентов и поиска хороших инфраструктурных решений.
Источник, аннотация препринта; в ней не названы авторы и организации, не перечислены все шесть оценённых моделей и не приведён итоговый рейтинг.
Ключевые факты
- Infrathon, бенчмарк долгих задач по оптимизации ИИ-инфраструктуры; оценены шесть моделей в 150 запусках по 24 часа, всего более 10 000 GPU-часов.
- Рейтинг моделей зависит от горизонта оценки: короткие замеры могут упускать и прирост от оптимизации, и смену относительного положения моделей.
- В 135 из 150 запусков агенты улучшали результат во второй половине бюджета времени.
- Claude Opus 5.5 поднял среднюю степень сжатия KV-кэша с 6,82% (кодек Quant-VideoGen, созданный людьми) до 19,86%.
- Барьеры для устойчивого улучшения: нарушения условий задачи, ненадёжное тестирование и преждевременное завершение.
Почему это важно
Большинство оценок агентов короткие, а реальная оптимизация инфраструктуры идёт часами и днями. По результатам авторов, при удлинении горизонта положение моделей относительно друг друга меняется, а в 135 из 150 запусков улучшения продолжались и во второй половине 24-часового бюджета. Если это подтвердится, короткие тесты дают неполную картину возможностей агентов. Пример с KV-кэшем (с 6,82% до 19,86% у Claude Opus 5.5) показывает, что агент может превзойти решение, созданное людьми.
Кому это важно
Исследователям, которые строят бенчмарки для агентов, и командам, которые оценивают модели для автоматизации оптимизации инфраструктуры ИИ: выбор длины замера, по результатам работы, влияет на вывод о том, какая модель лучше. Также работа интересна тем, кто занимается сжатием KV-кэша.
Как это применить
Авторы заявляют, что фреймворк Infrathon даёт ресурсы для построения длинных задач, оценки передовых агентов и поиска инфраструктурных решений. В аннотации не названы публикация кода или данных и условия доступа к бенчмарку, поэтому практически применить его пока можно, лишь проверив страницу самой работы. Из выводов можно взять идею оценивать агентов на горизонтах длиннее коротких тестов.
Можно ли доверять
Это препринт, а перед нами пересказ его аннотации: полных данных, методики и таблиц нет. Аннотация не называет авторов и организации, не перечисляет все шесть моделей и не даёт итогового рейтинга. Неясно, получен ли результат Claude Opus 5.5 в одном запуске или усреднён по нескольким, и на каком уровне задач. Метрика сжатия KV-кэша в аннотации не определена. Размер улучшений в тех 135 запусках не указан. Все выводы принадлежат самим авторам и независимо не проверены.
Риски и подводные камни
Сравнение с человеческим кодеком касается одной задачи, поэтому обобщать его на всю инфраструктуру ИИ рано. Сами авторы указывают на барьеры: агенты нарушают условия задач, тестируют ненадёжно и завершают работу преждевременно, что ставит под вопрос надёжность автономных улучшений. Бенчмарк дорог: 150 запусков заняли более 10 000 GPU-часов, что затрудняет воспроизведение.