Предложен SpecOPD: ускорение генерации нейросетей до 3,56 раза
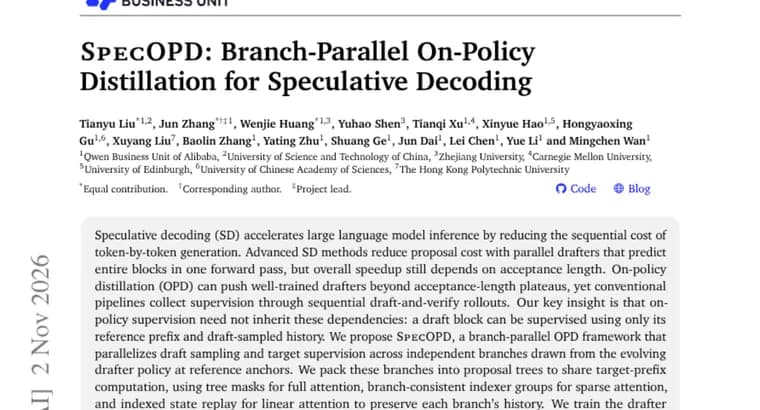
Спекулятивное декодирование (speculative decoding, SD) ускоряет работу больших языковых моделей: вместо посимвольной, токен за токеном, генерации небольшая «черновая» модель (drafter) предлагает варианты продолжения, а основная модель их проверяет. Продвинутые методы удешевляют предложение черновика с помощью параллельных drafter-моделей, которые предсказывают целый блок токенов за один прямой проход. Но итоговое ускорение всё равно упирается в длину принятой последовательности (acceptance length).
Добиться её роста помогает дистилляция на собственных траекториях (on-policy distillation, OPD): она способна вытолкнуть уже хорошо обученные черновые модели за плато по этому показателю. Проблема в том, что обычные конвейеры собирают обучающий сигнал последовательно, через циклы «черновик, проверка».
Ключевая идея авторов: такой надзор не обязан наследовать последовательные зависимости. Блок черновика можно контролировать, используя только его опорный префикс и историю, которую сам черновик и сгенерировал. На этом построен SpecOPD, каркас OPD с ветвлением и параллелизмом. Он параллельно выполняет выборку черновика и надзор со стороны целевой модели по независимым веткам, которые берутся из развивающейся политики черновой модели в опорных точках (anchors).
Ветки упаковываются в деревья предложений, чтобы разделить вычисления над префиксом целевой модели. Чтобы сохранить историю каждой ветки, для полного внимания используются древовидные маски, для разреженного, согласованные по веткам группы индексатора, для линейного, индексированное воспроизведение состояния. Черновую модель обучают с суррогатной функцией E2E-TV, которая напрямую нацелена на длину принятой последовательности.
Исследование охватывает целевые модели трёх типов: 8B с полным вниманием (GQA), 27B с полностью линейным вниманием (GQA, GDN) и 125B с разреженно-линейным (QSA, GDN). В нём участвуют три архитектуры параллельных черновиков (DFlash, DSpark и DFlash V2) и четыре предметные области: диалог, программирование, математика и агентные задачи.
Результаты, заявленные в аннотации: SpecOPD даёт до 41,45% более высокую среднюю длину принятой последовательности; пропускная способность по размеченным надзором токенам в 16,09 раза выше, чем у OPD с последовательными прогонами, в «родных» конфигурациях; ускорение генерации относительно авторегрессионного декодирования достигает 3,56 раза.
Ключевые факты
- SpecOPD, каркас дистилляции на собственных траекториях (OPD) для обучения черновых моделей спекулятивного декодирования: выборка черновика и надзор целевой модели идут параллельно по независимым веткам.
- Ключевая идея: блок черновика можно контролировать, используя только опорный префикс и историю, выбранную самим черновиком, последовательные прогоны «черновик, проверка» не нужны.
- Заявлено: до 41,45% рост средней длины принятой последовательности и до 3,56 раза ускорение генерации относительно авторегрессионного декодирования.
- Пропускная способность по токенам с надзором, в 16,09 раза выше, чем у OPD с последовательными прогонами, в «родных» конфигурациях.
- Проверка охватывает целевые модели 8B, 27B и 125B, три архитектуры черновиков (DFlash, DSpark, DFlash V2) и четыре области: диалог, код, математика, агентные задачи.
Почему это важно
Скорость генерации, одно из узких мест при использовании больших языковых моделей, а спекулятивное декодирование, один из способов её поднять. Выигрыш зависит от того, сколько токенов основная модель принимает из предложенного черновика. SpecOPD нацелен именно на это: он ускоряет обучение черновых моделей за счёт параллельного сбора надзора и напрямую оптимизирует длину принятой последовательности. По заявлению авторов, метод работает на моделях с разными типами внимания, включая линейное и разреженное.
Кому это важно
Прежде всего тем, кто занимается инференсом больших моделей и обучением черновых моделей для спекулятивного декодирования: это исследователи и инженеры, работающие над ускорением генерации. Для обычных пользователей нейросетей работа пока интереса не представляет: это препринт про технику обучения.
Как это применить
Из аннотации видно только общее устройство метода: ветки черновика берутся в опорных точках, упаковываются в деревья предложений, а черновик обучается с суррогатом E2E-TV. Об открытом коде, выпущенных моделях и затратах на обучение в источнике не сказано, поэтому оценить практическую применимость без полного текста статьи нельзя.
Можно ли доверять
Это препринт, опубликованный на странице статей Hugging Face; все цифры взяты из аннотации и пока не подтверждены независимо. Цифры 41,45% и 3,56 раза приведены как максимумы («до»): аннотация не уточняет, на какой целевой модели, архитектуре черновика и в какой области они получены, не называет базу сравнения для 41,45% и не даёт типичных значений. Рост в 16,09 раза относится к пропускной способности обучения «в родных конфигурациях» и не равен ускорению генерации.
Риски и подводные камни
Максимальные значения не стоит читать как среднюю ожидаемую выгоду: реальное ускорение будет зависеть от модели, черновика и типа задач. В аннотации нет абсолютных значений длины принятой последовательности, скорости в токенах в секунду и стоимости обучения. Метод опирается на довольно специальную инфраструктуру (деревья предложений, маски, воспроизведение состояния для линейного внимания), поэтому перенос на собственные системы может потребовать заметной инженерной работы.