Claude Opus 5 набрала лишь 45,7% в тесте VideoMemBench на память по видео
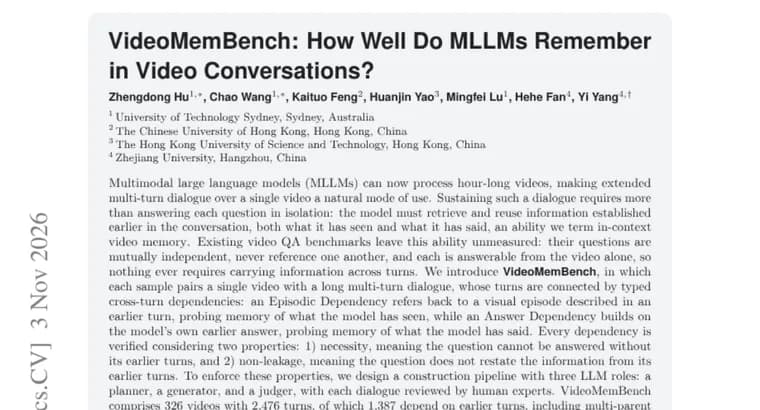
Мультимодальные большие языковые модели (MLLM) уже умеют обрабатывать часовые видео, поэтому длинный диалог по одному ролику становится обычным сценарием. Чтобы вести такой диалог, мало отвечать на каждый вопрос по отдельности: модель должна находить и использовать то, что установлено раньше в разговоре, и то, что она видела, и то, что сама сказала. Эту способность авторы называют «внутриконтекстной видеопамятью» (in-context video memory).
По словам авторов, существующие бенчмарки по видео этого не измеряют: их вопросы независимы друг от друга, не ссылаются один на другой, и на каждый можно ответить по одному лишь видео, переносить информацию между репликами нигде не требуется.
В новом бенчмарке VideoMemBench каждый образец, это одно видео и длинный многоходовой диалог, реплики которого связаны типизированными зависимостями. Зависимость от эпизода (Episodic Dependency) отсылает к визуальному эпизоду, описанному в одной из прошлых реплик, и проверяет память о том, что модель видела. Зависимость от ответа (Answer Dependency) опирается на собственный предыдущий ответ модели и проверяет память о том, что она сказала.
Каждая зависимость проверяется по двум свойствам: необходимость (на вопрос нельзя ответить без прошлых реплик) и отсутствие утечки (вопрос не пересказывает информацию из прошлых реплик). Для этого авторы построили конвейер из трёх ролей, которые выполняют языковые модели: планировщик, генератор и судья (judger). Каждый диалог дополнительно просматривают эксперты-люди.
В VideoMemBench 326 видео и 2 476 реплик; из них 1 387 зависят от более ранних реплик, включая зависимости сразу от нескольких предыдущих реплик и возвраты к давнему эпизоду разговора (long-range call-back). Среди более чем 20 проверенных открытых и закрытых MLLM лучший результат у Claude Opus 5, всего 45,7% по общей оценке. Авторы считают, что это подчёркивает сложность внутриконтекстной видеопамяти. Датасет и код оценки опубликованы.
Ключевые факты
- VideoMemBench: 326 видео и 2 476 реплик диалога, из которых 1 387 зависят от более ранних реплик.
- Два типа зависимостей: от эпизода (что модель видела) и от собственного ответа (что она сказала).
- Каждая зависимость проверяется на необходимость и отсутствие утечки; диалоги строят планировщик, генератор и судья на базе языковых моделей, а затем просматривают эксперты-люди.
- Из более чем 20 открытых и закрытых MLLM лучший общий результат у Claude Opus 5, лишь 45,7%.
- Датасет и код оценки опубликованы.
Почему это важно
Мультимодальные модели уже работают с часовыми видео, и диалог по одному ролику, естественный сценарий. Однако, как утверждают авторы, привычные тесты по видео проверяют вопросы по отдельности и не требуют помнить предыдущие реплики. VideoMemBench закрывает этот пробел: он измеряет, умеет ли модель держать в памяти и увиденное, и собственные прошлые ответы. Результат лучшей модели, 45,7%, показывает, что задача далека от решённой.
Кому это важно
Исследователям мультимодальных моделей, которым нужен тест на связность длинного диалога по видео. Разработчикам ассистентов, которые обсуждают с пользователем один и тот же ролик на протяжении многих реплик. Тем, кто выбирает модель для такой задачи и хочет понимать, что обычные видеобенчмарки эту способность не показывают.
Как это применить
Датасет и код оценки опубликованы, так что свою модель можно прогнать через VideoMemBench и сравнить с результатом Claude Opus 5 (45,7% по общей оценке). Полезно смотреть отдельно на реплики, зависящие от эпизода, и на реплики, зависящие от собственного ответа модели, чтобы понять, где именно она теряет нить. Ссылка на датасет и условия лицензии в тексте не приведены.
Можно ли доверять
Пересказ основан только на аннотации статьи, самой работы мы не видели. Числа и утверждения о бенчмарке принадлежат авторам. Часть данных собрана языковыми моделями (планировщик, генератор, судья), но каждый диалог просматривали эксперты-люди. Оценки других моделей, кроме лучшей, и сравнение с человеком в тексте не приведены, поэтому судить о разрыве между моделями и людьми по этому материалу нельзя.
Риски и подводные камни
Из аннотации неясно, как именно считается общая оценка 45,7%, как она делится между двумя типами зависимостей и какие модели выступают планировщиком, генератором и судьёй. Диалоги частично созданы самими языковыми моделями, что в принципе может влиять на трудность и стиль вопросов. Низкий результат лучшей модели говорит о сложности теста, но сам по себе не объясняет причин ошибок.