Предложен метод SynthSelf: дообучение малых моделей без забывания
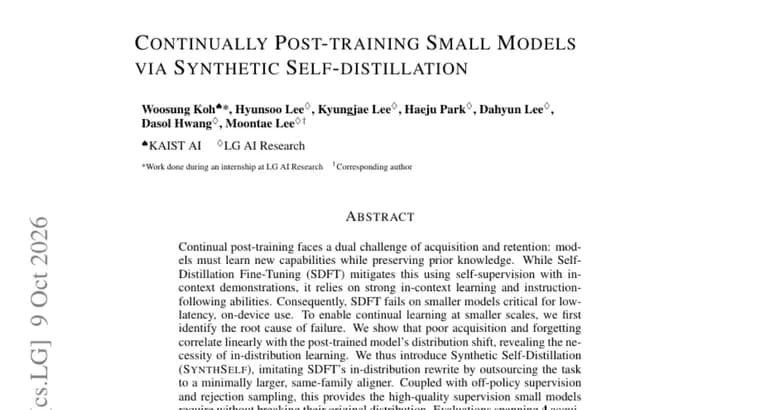
Статья посвящена непрерывному дообучению (continual post-training): модель должна освоить новые умения и при этом сохранить прежние знания. Авторы описывают это как двойную задачу, освоение нового (acquisition) и удержание старого (retention).
Отправная точка, метод Self-Distillation Fine-Tuning (SDFT). Он смягчает проблему с помощью самоконтроля на примерах, которые подаются прямо в контекст. Но, как пишут авторы, SDFT опирается на сильное обучение в контексте и хорошее следование инструкциям, поэтому на малых моделях, важных для работы с низкой задержкой и на устройстве пользователя, он не срабатывает.
Чтобы понять причину, авторы показывают, что плохое освоение нового и забывание линейно связаны со сдвигом распределения у дообученной модели. Из этого они делают вывод, что обучение должно идти «внутри распределения» модели (in-distribution).
На этом основан предложенный метод Synthetic Self-Distillation (SynthSelf). Он имитирует то, как SDFT переписывает данные внутри распределения модели, но поручает переписывание вспомогательной модели (aligner), чуть более крупной, чем малая, и из того же семейства. В сочетании с off-policy-сигналом обучения и отбраковывающей выборкой (rejection sampling) это, по утверждению авторов, даёт малой модели качественный обучающий сигнал, не выводя её за пределы исходного распределения.
Проверка охватывала 4 набора данных для освоения нового (один из них, смесь) и 14 бенчмарков на удержание знаний. По словам авторов, SynthSelf стабильно превосходит 6 методов, включая off-policy- и on-policy-дистилляцию, на 3 масштабах малых моделей. Дополнительные анализы, как сказано в аннотации, подтверждают, что метод открывает путь к эффективному непрерывному обучению малых моделей.
Ключевые факты
- Проблема: SDFT, по словам авторов, плохо работает на малых моделях, потому что требует сильного обучения в контексте и следования инструкциям.
- Диагноз авторов: плохое освоение нового и забывание линейно коррелируют со сдвигом распределения дообученной модели, поэтому нужно обучение внутри распределения.
- Суть SynthSelf: данные переписывает чуть более крупная вспомогательная модель того же семейства; дополнительно используются off-policy-сигнал и rejection sampling.
- Оценка: 4 набора данных для освоения нового (один, смесь), 14 бенчмарков на удержание знаний, 3 масштаба малых моделей.
- Заявленный результат: SynthSelf стабильно превосходит 6 методов, включая off- и on-policy-дистилляцию; числовые показатели в аннотации не приведены.
Почему это важно
Малые модели нужны там, где важны низкая задержка и работа прямо на устройстве, и именно на них, как утверждают авторы, не срабатывает SDFT. Если модель нужно периодически дообучать новому и она при этом забывает прежнее, практическая польза падает. Работа предлагает объяснение (сдвиг распределения) и способ его обойти, не требуя от самой малой модели сильного обучения в контексте.
Кому это важно
Исследователям и инженерам, которые дообучают небольшие модели для задач с низкой задержкой и локального запуска и сталкиваются с забыванием прежних умений. Также тем, кто следит за темой непрерывного обучения и дистилляции.
Как это применить
В аннотации не названы выпуск кода, моделей или данных, поэтому готового инструмента для использования здесь нет. Идея, которую можно взять на заметку, переписывать обучающие данные вспомогательной моделью того же семейства и чуть большего размера, чтобы не уводить малую модель от её исходного распределения; в связке с off-policy-сигналом и rejection sampling. Конкретные размеры вспомогательной модели в тексте не указаны.
Можно ли доверять
Источник, аннотация статьи, и все утверждения о превосходстве принадлежат самим авторам. В тексте нет числовых результатов (точности, величины улучшения, доли забывания), не названы три масштаба малых моделей, наборы данных, бенчмарки и сравниваемые методы, кроме SDFT. Оценить силу заявленного преимущества по одной аннотации нельзя.
Риски и подводные камни
Метод требует вспомогательной модели чуть большего размера из того же семейства, что добавляет зависимость от её наличия и качества. Измерения задержки и работы на устройстве в аннотации не приводятся: низкая задержка и локальный запуск названы лишь как мотивация. Вывод о линейной связи забывания со сдвигом распределения, утверждение авторов, и его общность за пределами проверенных наборов неизвестна.