Предложен метод data-space iteration: быстрая генерация без дискретизации потока
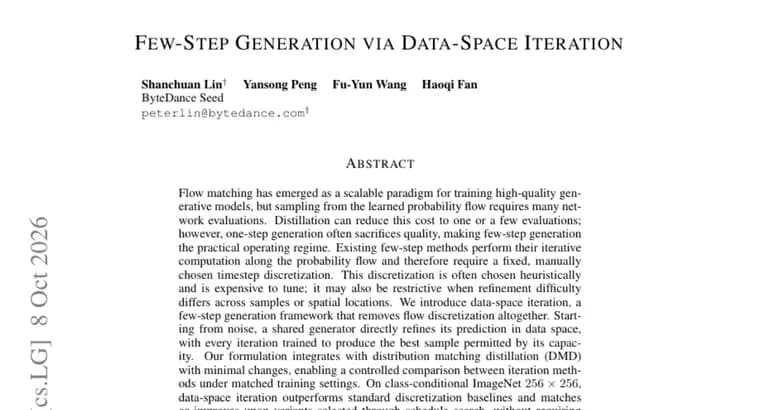
Статья «Few-Step Generation via Data-Space Iteration» посвящена ускорению генеративных моделей на основе flow matching (согласования потоков). Такие модели хорошо масштабируются и дают высокое качество, но чтобы получить сэмпл из выученного вероятностного потока, нужно много раз прогонять сеть. Дистилляция снижает стоимость до одного или нескольких вычислений, однако одношаговая генерация часто теряет в качестве, поэтому на практике рабочим режимом остаётся генерация за несколько шагов. Проблема, на которую указывают авторы: существующие немногошаговые методы выполняют итерации вдоль вероятностного потока, а значит, требуют фиксированной, заданной вручную дискретизации по времени. Её обычно подбирают эвристически, настройка обходится дорого, а ещё она может быть слишком жёсткой, когда сложность уточнения различается у разных образцов или в разных областях изображения. Предложенный подход, data-space iteration, вообще убирает дискретизацию потока. Начиная с шума, общий для всех итераций генератор напрямую уточняет своё предсказание в пространстве данных, а каждая итерация обучается выдавать лучший образец из тех, что допускает её ёмкость. Формулировка встраивается в дистилляцию с согласованием распределений (distribution matching distillation, DMD) с минимальными изменениями, что позволяет честно сравнивать методы итерации при одинаковых условиях обучения. Результат, заявленный авторами: на классово-условной генерации ImageNet 256x256 data-space iteration превосходит стандартные базовые варианты с дискретизацией и сравним с вариантами, подобранными через поиск расписания, либо лучше их, причём без обучения под конкретное расписание. Из этого авторы делают вывод, что метод, простая и эффективная альтернатива дискретизированной итерации в пространстве потока для быстрой генерации.
Ключевые факты
- Метод data-space iteration убирает фиксированную, подбираемую вручную дискретизацию потока в немногошаговой генерации.
- Начиная с шума, общий генератор на каждой итерации напрямую уточняет предсказание в пространстве данных.
- Подход встраивается в дистилляцию с согласованием распределений (DMD) с минимальными изменениями и допускает сравнение методов при одинаковых условиях обучения.
- На классово-условном ImageNet 256x256 метод, по заявлению авторов, превосходит стандартные базовые варианты и сравним с вариантами после поиска расписания или лучше них.
- Обучение под конкретное расписание шагов не требуется.
Почему это важно
Генерация за несколько шагов, практический режим для быстрых генеративных моделей: одношаговая часто теряет в качестве, а полный прогон слишком дорог. Выбор шагов по времени при этом остаётся ручной эвристикой, которую дорого настраивать. Работа предлагает обойтись без такой дискретизации вовсе, и в этом её основная идея.
Кому это важно
Исследователям и инженерам, которые занимаются дистилляцией и ускорением моделей на основе flow matching и диффузии, особенно тем, кто тратит время на подбор расписания шагов и использует DMD.
Как это применить
Это научная статья о методе, а не готовый продукт. Практическая сторона: метод встраивается в DMD с минимальными изменениями, то есть может быть добавлен в уже существующий пайплайн дистилляции. В описании не упомянуты ни выпуск кода, ни веса модели, ни вычислительные затраты, поэтому оценить трудоёмкость воспроизведения по этому тексту нельзя.
Можно ли доверять
Все утверждения о результатах принадлежат самим авторам статьи и приведены в аннотации. Названы только оценка на классово-условном ImageNet 256x256 и сравнение со «стандартными базовыми вариантами» и вариантами после поиска расписания; конкретные числа (FID, число шагов, ускорение), перечень сравниваемых методов, авторы и организации в тексте не указаны. Утверждение о преимуществе стоит рассматривать как заявление, которое нужно проверять по полному тексту статьи.
Риски и подводные камни
Заявленное преимущество показано на одном бенчмарке, ImageNet 256x256 с условием на класс; в тексте не сказано об оценке на других наборах данных, разрешениях или задачах, например генерации по тексту. Не указаны число итераций и объём вычислений, поэтому нельзя судить о выигрыше в скорости. Формулировка «превосходит или не хуже» относительно вариантов после поиска расписания не даёт количественного отрыва.