Предложен метод MRTPO: каждая награда в RL получает свои токены
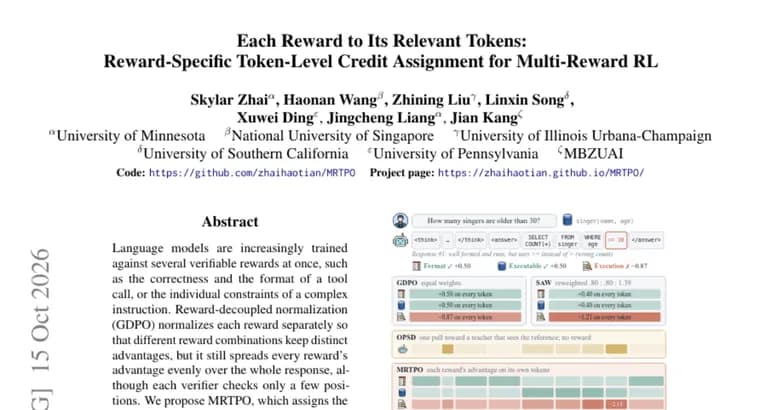
Языковые модели всё чаще обучают с подкреплением сразу по нескольким проверяемым наградам. Например, отдельно оценивают корректность и формат вызова инструмента или каждое из ограничений в сложной инструкции.
Существующий подход GDPO (reward-decoupled normalization, нормализация с разделением наград) нормализует каждую награду отдельно, чтобы разные сочетания наград сохраняли различимые преимущества (advantage). Но, как отмечают авторы, он по-прежнему равномерно распределяет преимущество каждой награды по всему ответу, хотя каждый верификатор проверяет лишь несколько позиций.
Авторы предлагают метод MRTPO. Он назначает преимущество каждой награды тем токенам, которые к ней относятся, опираясь на информацию, которую проверяет её верификатор. При этом не нужны вспомогательные модели и токен-уровневая разметка.
Механика такая: для каждой награды политика (обучаемая модель) заново «проигрывает» собственный ответ с информацией верификатора этой награды и без неё. Затем для каждого токена считается расстояние Йенсена, Шеннона между двумя распределениями следующего токена. Это расстояние служит мерой релевантности токена и определяет, как перераспределяется преимущество.
По заявлению авторов, на text-to-SQL, следовании инструкциям с несколькими ограничениями и вызове инструментов MRTPO сходится быстрее и показывает лучшее качество, чем сравниваемые методы.
Ключевые факты
- MRTPO, метод для обучения с подкреплением по нескольким проверяемым наградам: преимущество каждой награды назначается только релевантным ей токенам.
- Отправная точка, GDPO: он нормализует награды раздельно, но равномерно размазывает преимущество каждой награды по всему ответу, хотя верификатор проверяет лишь несколько позиций.
- Релевантность токена измеряется так: модель повторно проигрывает свой ответ с информацией верификатора и без неё, и считается расстояние Йенсена, Шеннона между распределениями следующего токена.
- Вспомогательные модели и токен-уровневая разметка не требуются.
- Авторы заявляют более быструю сходимость и лучшее качество на text-to-SQL, следовании инструкциям с несколькими ограничениями и вызове инструментов.
Почему это важно
Обучение с несколькими проверяемыми наградами становится обычным делом: так учат вызову инструментов и выполнению сложных инструкций. Если каждая награда оценивает лишь небольшую часть ответа, равномерное распределение её сигнала по всем токенам размывает обучение. MRTPO пытается адресовать сигнал туда, где он действительно относится к делу, и при этом не требует разметки по токенам.
Кому это важно
Прежде всего исследователям и инженерам, которые дообучают языковые модели с подкреплением на задачах с проверяемыми наградами: генерация SQL-запросов, следование инструкциям, вызов инструментов. Обычному пользователю нейросетей результат пока напрямую не заметен.
Как это применить
Идею можно держать в голове при построении RL-пайплайна с несколькими верификаторами: вместо равномерного распределения преимущества по ответу смотреть, какие токены связаны с конкретной наградой. Источник не называет релиз кода, лицензию, базовые модели и наборы данных, поэтому практическое воспроизведение потребует обращения к самой статье.
Можно ли доверять
Это препринт, представленный на странице Hugging Face Papers; все утверждения о превосходстве исходят от самих авторов. В источнике нет числовых результатов, не названы сравниваемые методы, кроме GDPO, а также авторы, модели и наборы данных. Оценить масштаб улучшения по этому описанию нельзя.
Риски и подводные камни
Заявление «быстрее сходится и работает лучше» дано без цифр и без перечня конкурентов, так что величина выигрыша неизвестна. Описание не говорит об ограничениях метода и о дополнительных вычислительных затратах на повторное проигрывание ответа для каждой награды. Универсальность подхода за пределами трёх названных задач в источнике не показана.