Предложен метод FAPL: видеомодель учат использовать признаки MLLM
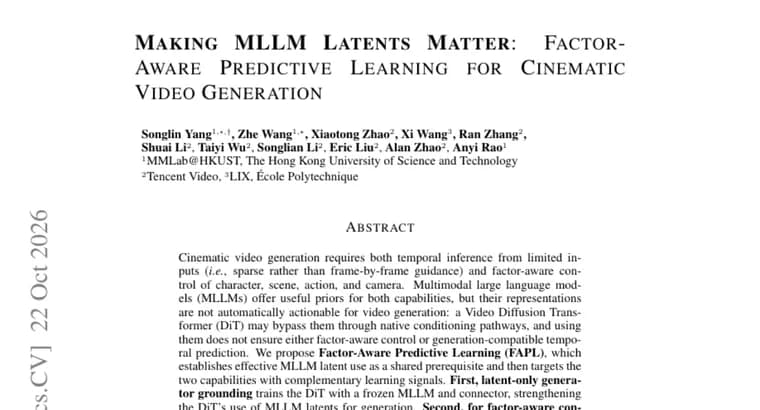
Статья посвящена кинематографичной генерации видео. По мнению авторов, для неё нужны две способности: временной вывод по ограниченным входным данным (то есть управление разреженными подсказками, а не покадровое) и контроль по факторам: персонаж, сцена, действие и камера.
Мультимодальные большие языковые модели (MLLM) содержат полезные априорные знания для обоих умений. Но, как пишут авторы, их представления не становятся автоматически пригодными для генерации видео. Видео-диффузионный трансформер (Video DiT) может обойти их через собственные каналы условия, а само использование MLLM не гарантирует ни контроля по факторам, ни временного предсказания, совместимого с генерацией.
Для решения предложен метод Factor-Aware Predictive Learning (FAPL). Он сначала делает эффективное использование скрытых представлений (латентов) MLLM общей предпосылкой, а затем решает две задачи с помощью взаимодополняющих обучающих сигналов. Обучение идёт в несколько этапов.
Первый этап: «заземление» генератора только по латентам. DiT обучают при замороженных MLLM и соединительном модуле (коннекторе), чтобы он сильнее опирался на латенты MLLM при генерации.
Второй этап, для контроля по факторам: пары видео задают изменение целевого фактора при сохранении остальных, а замена отрезков, соответствующих фактору (factor-span replacement), учит DiT воплощать это соотношение в выходном видео.
Третий этап, для временного вывода: наблюдения «только текст» и «текст плюс полное видео» ведут к одной и той же видеоцели. Затем обученный DiT замораживают, а MLLM и коннектор оптимизируют через него. Так обучаются представления по ограниченному входу, пригодные для генерации, а реконструкция по полному наблюдению сохраняется как дополнительный режим обучения.
В экспериментах, по заявлению авторов, метод стабильно лучше базовых подходов на трёх задачах: генерация видео из разреженных данных (sparse-to-video), редактирование по факторам и генерация нескольких планов (multi-shot). Эксперименты, как утверждается, также подтверждают вклад FAPL в использование признаков MLLM, временной контроль и согласование факторов.
Ключевые факты
- FAPL (Factor-Aware Predictive Learning), метод обучения, который заставляет Video DiT реально использовать латенты мультимодальной языковой модели, а не обходить их через родные каналы условия.
- Цель, кинематографичная генерация видео: временной вывод по разреженным входам и контроль над персонажем, сценой, действием и камерой.
- Обучение поэтапное: сначала DiT при замороженных MLLM и коннекторе, затем обучение контроля по факторам на парах видео и временного вывода, где MLLM и коннектор оптимизируют через замороженный DiT.
- Авторы заявляют стабильное превосходство над базовыми подходами на трёх задачах: sparse-to-video, редактирование по факторам и multi-shot генерация.
Почему это важно
Работа затрагивает известную трудность современных систем видеогенерации: даже если подключить мощную мультимодальную языковую модель, генератор может не использовать её представления. Авторы предлагают способ приучить Video DiT опираться на латенты MLLM и показывают, как на этой основе получить управление по факторам (персонаж, сцена, действие, камера) и работу с разреженными подсказками. Это шаг к более управляемой кинематографичной генерации, включая несколько планов.
Кому это важно
Исследователям видеогенерации и мультимодальных моделей, интересующимся тем, как связывать MLLM с диффузионными видеомоделями. Также тем, кто работает над редактированием видео и генерацией многоплановых роликов.
Как это применить
Пока это описание метода в аннотации статьи. Об открытом коде, весах или готовых инструментах в источнике не сказано. Практическая идея для разработчиков, поэтапный рецепт обучения: сначала закрепить использование латентов MLLM в генераторе, затем отдельно учить контроль по факторам и временной вывод.
Можно ли доверять
Все выводы взяты из аннотации и являются заявлениями самих авторов. В источнике нет количественных результатов, не названы базовые подходы, не указаны наборы данных и размеры моделей, поэтому заявление о стабильном превосходстве на трёх задачах нельзя оценить по приведённому тексту. Нужна проверка по полному тексту статьи и независимое воспроизведение.
Риски и подводные камни
Из аннотации не видно, насколько метод масштабируется и каковы его затраты на обучение: данных о вычислительной стоимости нет. Многоэтапное обучение с замораживанием и разморозкой отдельных частей (DiT, MLLM, коннектор) усложняет воспроизведение. Ограничения и случаи неудач в источнике не обсуждаются, поэтому оценивать применимость метода рано.