Предложен DecisionRank: ранжировщик на 1,7B обошёл 27B-учителя на TREC DL
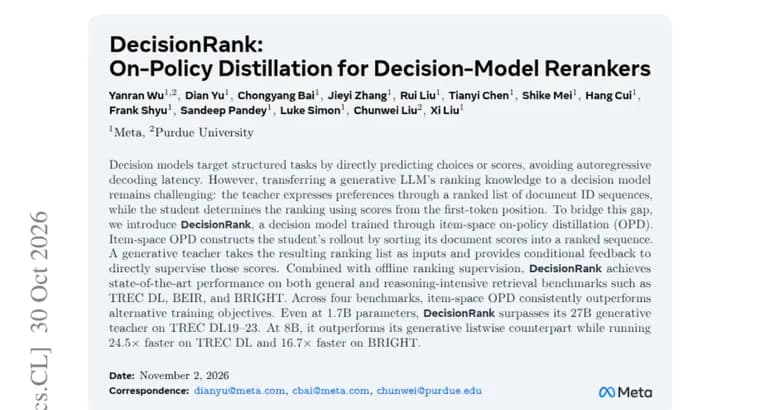
В препринте предложен DecisionRank, «решающая» модель (decision model) для ранжирования документов. Такие модели не генерируют текст токен за токеном, а напрямую предсказывают выбор или оценки (скоры), поэтому не страдают от задержки авторегрессионного декодирования.
Проблема, на которую нацелена работа: передать знания о ранжировании от генеративной большой языковой модели (учителя) к решающей модели (ученику) непросто. Учитель выражает предпочтения как ранжированный список последовательностей идентификаторов документов, а ученик определяет порядок по оценкам в позиции первого токена.
Чтобы закрыть этот разрыв, авторы применяют item-space on-policy distillation (OPD), дистилляцию «по собственной траектории» в пространстве документов. Ученик сортирует свои оценки документов и тем самым строит собственный ранжированный список (rollout). Генеративный учитель получает этот список на вход и даёт условную обратную связь, которая напрямую обучает эти оценки. Дополнительно используется офлайн-обучение на готовой разметке ранжирования.
Результаты, заявленные авторами: DecisionRank показывает state-of-the-art на общих и требующих рассуждений бенчмарках поиска, TREC DL, BEIR и BRIGHT. На четырёх бенчмарках item-space OPD последовательно превосходит альтернативные целевые функции обучения. Даже при 1,7B параметров DecisionRank обходит своего 27B-учителя на TREC DL19-23. Версия на 8B превосходит генеративный листвайз-аналог (ранжирование списка целиком) и работает быстрее: в 24,5 раза на TREC DL и в 16,7 раза на BRIGHT.
Ключевые факты
- DecisionRank, решающая модель-ранжировщик, обученная через item-space on-policy distillation (OPD) от генеративного LLM-учителя.
- Ученик сортирует свои оценки документов в ранжированный список, а учитель по этому списку даёт условную обратную связь, напрямую обучающую оценки.
- Версия на 1,7B параметров превзошла 27B генеративного учителя на TREC DL19-23.
- Версия на 8B обошла генеративный листвайз-аналог и работает в 24,5 раза быстрее на TREC DL и в 16,7 раза быстрее на BRIGHT.
- На четырёх бенчмарках item-space OPD, по заявлению авторов, стабильно лучше альтернативных целей обучения.
Почему это важно
Ранжирование найденных документов, ключевой этап поиска и систем с подключением внешних знаний, а генеративные ранжировщики на больших моделях медленны из-за пошагового декодирования. Работа показывает способ перенести их качество в быструю решающую модель. Если заявленное подтвердится, компактная модель на 1,7B способна не уступать крупному учителю на TREC DL19-23, а модель на 8B, заметно ускорять ранжирование (в 24,5 раза на TREC DL и в 16,7 раза на BRIGHT).
Кому это важно
Исследователям информационного поиска и дистилляции моделей, а также командам, которые строят поисковые системы и ранжирование и упираются в задержку генеративных ранжировщиков.
Как это применить
В источнике, только аннотация статьи. Практическая идея, которую в ней можно увидеть: ученик строит свой ранжированный список по сортировке оценок, а учитель оценивает именно этот список и корректирует оценки; всё это сочетается с обычным офлайн-обучением ранжированию. Упоминаний о выпуске кода или весов моделей в тексте нет в перечне заявленного, так что готовый инструмент из аннотации не следует.
Можно ли доверять
Это препринт, и все результаты в тексте, заявления самих авторов в аннотации. Цифры даны без значений метрик: сообщается лишь о превосходстве и кратности ускорения. В аннотации не названы авторы и организации, не указана 27B-модель учителя и базовые модели учеников. Неясно, средним, медианным или максимальным является ускорение, и на каком оборудовании оно измерено. Превосходство 1,7B-модели над учителем заявлено только для TREC DL19-23. Независимой проверки в источнике нет.
Риски и подводные камни
Ускорение в 24,5 и 16,7 раза нельзя переносить на свои условия без собственных замеров: способ и оборудование измерения не раскрыты. Заявление о state-of-the-art не сопровождается указанием, насколько именно метод опережает предыдущие, а превосходство над учителем подтверждено лишь на одном семействе бенчмарков. Метод требует генеративного учителя, который оценивает списки ученика, так что обучение зависит от наличия сильной модели-учителя.