180B-модель Qwen3.8-Flash-Next запустили на Mac с 32 ГБ через Transformers: ~14 ток/с
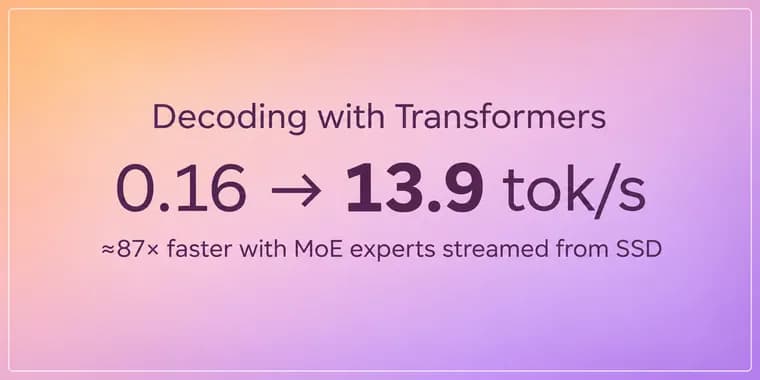
Автор поста в блоге Hugging Face пытается меньше зависеть от онлайн-моделей и запускать крупные модели локально. Дома у него ПК с двумя RTX 4090 (он называет его Orthrus), для работы, MacBook M5 с 32 ГБ унифицированной памяти. После совета в соцсетях он присмотрелся к Strata, движку инференса для MoE-моделей (смесь экспертов) вроде Qwen: в видеопамяти остаются только «горячие» эксперты, остальные лежат в RAM или на диске. Поскольку эксперты составляют более 90% весов MoE-модели (по словам автора), 180B-модель можно запускать на GPU с куда меньшим объёмом памяти. Strata на Mac M4 с 32 ГБ, по найденной автором статье, выдаёт на Qwen3.8-Flash-Next 13,5 ток/с и быстрее llama.cpp. Для работы с кодинг-агентами автору этого мало, но задача его заинтересовала.
Перед этим он сравнил, как поступают с MoE-моделью, не помещающейся в память, другие стеки. llama.cpp держит эксперты на CPU и считает их там же; хорошо, пока эксперты влезают в RAM, а если нет, страничный кэш «молотит» впустую. Недавно добавленный GPU-кэш экспертов (--moe-cache-mib) дробит граф (2 разбиения на токен превращаются в 50) и теряет около 10% даже когда всё помещается. В vLLM флаг --cpu-offload-gb кладёт веса в закреплённую RAM, а ядра читают их по PCIe на каждом токене; кэша и дискового уровня нет. Transformers выгружает через Accelerate целым слоем: на каждом токене копируются все эксперты каждого выгруженного слоя, чтобы использовать 8-10 из них, без кэша и учёта маршрутизации; на Mac, где CPU и GPU делят память, «выгрузка на CPU» вообще ничего не освобождает. На Qwen3.6-35B-A3B с одной A10G (24 ГБ) выгрузка только экспертов вдвое ускоряет vLLM (FP8 даёт ещё прирост), а другой бэкенд выгрузки vLLM, копирующий группы слоёв заранее, работал медленнее 1 ток/с. Вывод автора: если эксперты помещаются в RAM, llama.cpp трудно побить; если нет, нужно подгружать только выбранных маршрутизатором экспертов через ограниченный кэш.
Весь код (PR в Transformers, пакет под конкретную модель и ядра Metal) написан с помощью ИИ; вклад автора, выбор, что пробовать, чтение профилей и решение, что оставить. Начал он с OLMoE-1B-7B, которая помещается в память. Первая версия, эксперты на диске, LRU-кэш на устройстве и цикл на Python по одному эксперту, давала 10,1 ток/с против ~32 у обычного Transformers: упёрлись не в ввод-вывод, а в цикл. Ключевая идея проекта, превратить кэш в пул слотов: один заранее выделенный тензор на устройстве на все слои плюс таблица «номер эксперта → слот» для каждого слоя. После переотображения номеров экспертов пул выглядит как обычный банк экспертов, и grouped_mm работает на нём без изменений: 34,6 ток/с против 38,1 у обычного Transformers. Затем это оформили как опцию from_pretrained в PR huggingface/transformers#50717; API ещё обсуждается с мейнтейнерами.
На целевой Qwen3.8-Flash-Next (48 слоёв по 512 экспертов, 10 активных, 121 ГБ в FP8) добавилась проблема: ещё и 51 ГБ таблицы n-грамм, для которых нужен отдельный дисковый путь. Решение: эксперты в 3 битах (49 ГБ на диске, 12 ГиБ кэша на устройстве), плотные слои в 8 битах (~5,4 ГБ, +0,2% перплексии относительно BF16), таблица n-грамм остаётся на диске и читается по строкам. Конвертация занимает около 5 часов; после загрузки модель занимает ~18 ГиБ, а 6K-промпт даёт пик 25,4 ГиБ, автору приходится закрывать браузер, иначе macOS уходит в своп. Промахи кэша читают 8 потоков ввода-вывода (одно непрерывное чтение на эксперта), а роутеры двух следующих слоёв запускаются заранее, чтобы угадать, что подгружать.
Первая версия давала около 10 ток/с. Ускорили её так: принудительная отправка работы на GPU после каждого блока (PyTorch на MPS придерживает мелкие ядра до синхронизации), +10%; ядра Metal для Gated DeltaNet и hyper-connections; переход на GGUF-веса Strata (трафик плотных весов на токен упал с 5,4 до 3,9 ГБ, размер эксперта, с 2,15 до 1,75 МБ); для предзаполнения (prefill), более крупные блоки и чтение экспертов следующего слоя во время расчёта текущего (с 68 до ~228 ток/с); для длинных документов, внимание только по выбранным индексатором блокам и KV-кэш, растущий на месте. Итог на том же M5 с теми же промптами: около 14 ток/с, примерно на 6% медленнее Strata на коротком декодировании, предзаполнение чуть быстрее. Оставшееся отставание, в основном обращения хоста, ~10 мс на токен: GPU простаивает, пока Python ставит в очередь следующий слой. Strata ставит в очередь всю работу токена заранее, а PyTorch такого не даёт. Настоящим решением была бы нативная операция в потоке MPS PyTorch, но автор её не писал из-за риска зависаний.
Вывод автора: Transformers Strata не обогнал, а закрыть последние ~6% можно только глубокими изменениями в стеке. Для его кодинг-агентов 14 ток/с всё ещё слишком медленно, поэтому реальную работу по-прежнему делает Orthrus. Зато проект получился поучительным: видно, насколько разрежена маршрутизация, что даёт кэш экспертов и куда уходит пропускная способность памяти. Ядра Metal опубликованы на Hub, бенчмарки лежат в Space tarekziade/moe-expert-streaming.
Ключевые факты
- Потоковая подгрузка экспертов MoE с SSD в Transformers (PR huggingface/transformers#50717, API ещё обсуждается) запускает 180B-модель Qwen3.8-Flash-Next на MacBook M5 с 32 ГБ.
- Результат, около 14 ток/с, примерно на 6% медленнее движка Strata на коротком декодировании; предзаполнение чуть быстрее. Первая версия давала около 10 ток/с.
- Ключевая идея: кэш экспертов как пул слотов, общий для всех слоёв, поэтому grouped_mm работает без своих ядер матричного умножения (OLMoE: 34,6 ток/с против 38,1 у обычного Transformers).
- Для запуска: эксперты в 3 битах (49 ГБ на диске, 12 ГиБ кэша), плотные слои в 8 битах, таблица n-грамм на 51 ГБ читается с диска; после загрузки ~18 ГиБ, пик 25,4 ГиБ на 6K-промпте.
- Автор считает 14 ток/с слишком медленным для кодинг-агентов; оставшиеся ~6% требуют контроля над синхронизацией по слоям, которого в PyTorch сейчас нет.
Почему это важно
Пост показывает, что 180B MoE-модель с 121 ГБ экспертов в FP8 можно запустить на ноутбуке с 32 ГБ унифицированной памяти, если читать с SSD только тех экспертов, которых выбрал маршрутизатор, и держать их в ограниченном кэше. Скорость около 14 ток/с лишь примерно на 6% уступает специализированному движку Strata, при этом всё работает через Transformers, стандартную библиотеку, на которой многие и так работают с моделями. Любопытна и техническая находка: пул слотов позволяет использовать готовые быстрые ядра grouped_mm вместо собственных.
Кому это важно
Тем, кто запускает крупные MoE-модели локально на ограниченном железе, на Mac с унифицированной памятью или GPU с небольшим объёмом видеопамяти. Также разработчикам инференса и участникам Transformers: автор приглашает обсудить подход и API, а сравнение llama.cpp, vLLM и Accelerate-выгрузки даёт готовую картину слабых мест каждого из них при нехватке памяти.
Как это применить
Обобщённую реализацию можно поставить из PR: pip install с адресом git+https://github.com/huggingface/transformers.git@refs/pull/50717/head. Модель загружается через from_pretrained с device_map вида {"": "mps", "experts.*": "disk"}, квантованием MetalConfig(bits=8) и параметром experts_offload (размер кэша 12 ГиБ и путь к экспертам в 3 битах). Подготовленные веса лежат в репозитории tarekziade/Qwen3.8-Flash-Next-expert-streaming, а конвертация занимает около 5 часов. Нужно учесть запас памяти: на 32 ГБ автору приходится закрывать браузер, иначе macOS начинает использовать своп. Способ, по словам автора, работает для MoE-моделей со стандартной раскладкой экспертов.
Можно ли доверять
Это личный эксперимент автора, а не официальный релиз: PR в Transformers ещё обсуждается, о принятии в основную ветку в тексте не сказано. Измерения автор делал сам на одном MacBook M5 при одинаковых промптах, в жадном режиме, с выключенными thinking, MTP и спекулятивными черновиками; Strata 0.1.60 использовал эксперты IQ3_XXS. Точная скорость Strata на M5 в тексте не названа: 13,5 ток/с относятся к M4 из другой статьи. Оценка +0,2% перплексии приведена только для 8-битных плотных слоёв; качество 3-битных экспертов отдельно не измерялось. Весь код автор написал с помощью ИИ и сам это прямо отмечает.
Риски и подводные камни
Автор сам считает скорость в 14 ток/с слишком низкой для работы с кодинг-агентами и продолжает использовать для этого свой ПК с двумя RTX 4090. Память почти на пределе: пик 25,4 ГиБ на 6K-промпте, при загруженном браузере начинается своп. Оставшееся отставание в ~6% упирается в обращения хоста (~10 мс на токен) и в отсутствие в PyTorch нужного управления синхронизацией на MPS; нативную операцию автор не стал делать из-за риска зависаний. Попытка обойти это ядром, ждущим флага от CPU, оказалась ненадёжной: GPU замечал запись от секунды до бесконечности. Также vllm-metal не запускает эту модель на 32 ГБ из-за таблиц n-грамм в памяти, а само API потоковой подгрузки может измениться по итогам обсуждения с мейнтейнерами.
«Transformers не обогнал Strata, а чтобы закрыть последние ~6%, понадобятся более глубокие изменения в стеке.»
— автор поста в блоге Hugging Face