PlannerForge: открытые модели сравнялись с коммерческими в тестах автопилотов
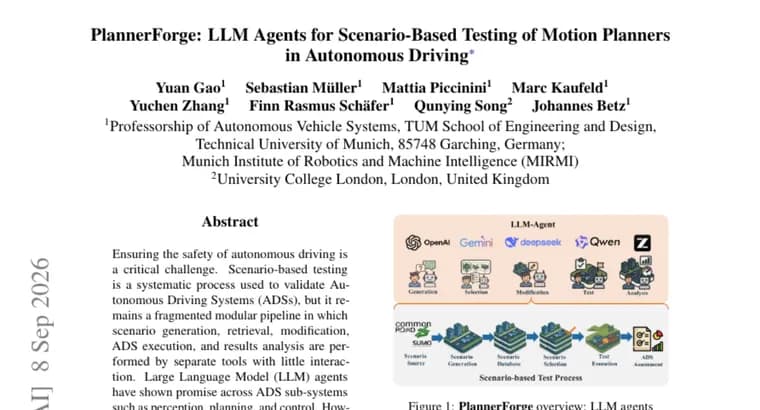
Тестирование автономных систем вождения (ADS) по сценариям обычно распадается на отдельные несвязанные инструменты: генерация сценария, поиск подходящего, его модификация, запуск самой системы вождения и анализ результатов делаются разными программами, которые слабо взаимодействуют друг с другом. Исследователи представили PlannerForge, фреймворк ИИ-агентов на основе больших языковых моделей (LLM), который охватывает весь этот конвейер целиком, от генерации сценария до оценки системы вождения, и добавляет две новые стадии: улучшение системы вождения и её сравнительный бенчмаркинг. По утверждению авторов, ни одна прежняя работа не покрывала весь конвейер тестирования по сценариям единым фреймворком на базе LLM-агентов.
PlannerForge проверили на 10 готовых LLM по всем задачам конвейера, генерации, отборе, модификации сценариев, маршрутизации между модулями системы вождения и тестировании планировщика движения, при 5 разных вариантах формирования запроса к модели. Лучшие результаты по отдельным задачам составили от 0,88 до 1,00. Открытые модели с 20-35 млрд параметров сравнялись с коммерческими API на большинстве задач; например, модель Qwen3.6:35B совпала по качеству с коммерческими API на трёх задачах из пяти. При сквозном прохождении всей цепочки модулей подряд сохраняется 83% исходных запросов на коммерческих моделях и 78%, на открытых.
По генерации сценариев на естественном языке PlannerForge обошёл существующую систему Scenario Factory 2.0: из 200 сгенерированных сценариев исполняемыми оказались 193 против 144 у конкурента, а доля реализованных запрошенных атрибутов города, дороги и транспортных средств составила 92-96%. При отборе наиболее релевантного сценария (ранг 1) точность PlannerForge, 92,0% против 67,5% у метода BM25. На задаче физически корректных правок сценария PlannerForge показал результат не ниже 94% против 31% у метода From-Words-to-Collisions.
Отдельный эксперимент с настройкой стоимости (cost-tuning) на выборке из 400 сценариев поднял долю успешных проездов планировщика с 50,4% до 70,2% и снизил долю столкновений с 19,0% до 8,4%, без дополнительного дообучения модели под конкретный домен.
Ключевые факты
- PlannerForge объединяет весь конвейер тестирования автономного вождения по сценариям, генерацию, отбор, модификацию, маршрутизацию по модулям и тестирование планировщика, и добавляет две новые стадии: улучшение и бенчмаркинг системы вождения.
- Фреймворк проверили на 10 готовых LLM при 5 вариантах формирования запроса; лучшие результаты по отдельным задачам, от 0,88 до 1,00.
- Открытые модели с 20-35 млрд параметров сравнялись с коммерческими API на большинстве задач; модель Qwen3.6:35B совпала с ними на трёх задачах из пяти.
- По генерации исполняемых сценариев PlannerForge обошёл Scenario Factory 2.0 (193 против 144 из 200), по отбору, метод BM25 (92,0% против 67,5%), по физически корректным правкам, метод From-Words-to-Collisions (не менее 94% против 31%).
- Настройка стоимости на выборке из 400 сценариев подняла успешность планировщика с 50,4% до 70,2% и снизила долю столкновений с 19,0% до 8,4% без дообучения под конкретный домен.
Почему это важно
Тестирование автономного вождения по сценариям сейчас держится на отдельных несвязанных инструментах для генерации, поиска, модификации сценариев, запуска системы вождения и анализа результатов. PlannerForge, первый, по словам авторов, фреймворк ИИ-агентов, который объединяет весь этот конвейер в единую систему и добавляет две новые ИИ-управляемые стадии: улучшение системы вождения и её сравнительный бенчмаркинг.
Кому это важно
Разработчикам и исследователям автономного вождения, командам, которые занимаются тестированием планировщиков движения и систем вождения по сценариям, а также инженерам, выбирающим между дорогими коммерческими LLM-API и открытыми моделями для подобных задач.
Как это применить
PlannerForge проверили на 10 готовых LLM по всем задачам конвейера при 5 вариантах формирования запроса. Открытые модели с 20-35 млрд параметров сравнялись с коммерческими API на большинстве задач, а на отдельных этапах, генерации исполняемых сценариев, отборе наиболее релевантного варианта и физически корректных правках, PlannerForge превзошёл существующие методы сравнения (Scenario Factory 2.0, BM25, From-Words-to-Collisions). Настройка стоимости на 400 сценариях заметно подняла долю успешных проездов планировщика и снизила долю столкновений без дополнительного дообучения под конкретный домен.
Можно ли доверять
Данные взяты из препринта на Hugging Face Papers / arXiv, это самостоятельная оценка авторов на их же тестовом наборе задач и на сравнении с выбранными ими методами (BM25, Scenario Factory 2.0, From-Words-to-Collisions), без независимого рецензирования. В самом тексте аннотации не названы ни авторы, ни организация, ни дата публикации, ни конкретные коммерческие API, с которыми сравнивалась модель Qwen3.6:35B; не раскрыто и то, что именно входит в «настройку стоимости» и как измерялось удержание исходных запросов при сквозном прохождении конвейера.
Риски и подводные камни
Все цифры получены на собственном тестовом наборе авторов, поэтому неясно, насколько результаты переносятся на реальные дорожные условия и на другие бенчмарки. Открытые модели совпадают с коммерческими API не на всех задачах, а лишь на большинстве: например, Qwen3.6:35B совпадает с ними по качеству только на трёх задачах из пяти. Даже при сквозном прохождении всей цепочки модулей часть исходных запросов теряется, 17% на коммерческих моделях и 22% на открытых, то есть ни одна конфигурация не сохраняет сценарий в 100% случаев.