PARSER: субагенты читают документ параллельно и ускоряют вывод ИИ-агента до 11 раз
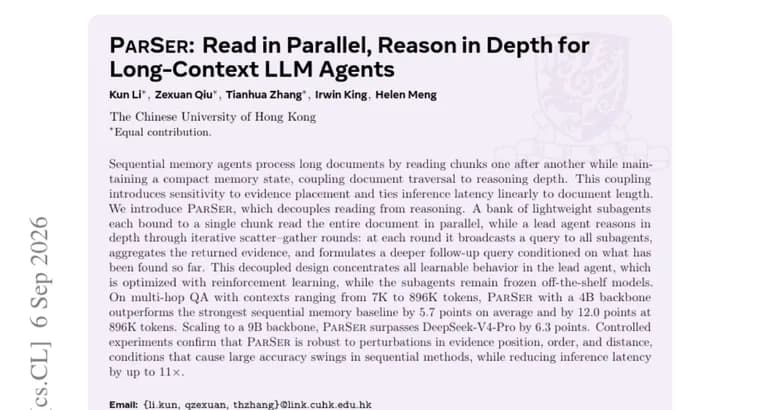
Агенты с последовательной памятью читают длинные документы кусок за куском, обновляя по ходу компактное состояние памяти. Из-за этого просмотр документа жёстко связан с глубиной рассуждения: такие агенты чувствительны к тому, где именно в документе лежит нужный факт, а задержка вывода растёт линейно с длиной документа, чем длиннее текст, тем медленнее ответ.
Исследователи предложили архитектуру PARSER, которая разрывает эту связь: чтение документа и рассуждение над ним выполняют разные агенты. Набор легковесных субагентов, каждый привязан к одному фрагменту документа, читает весь текст одновременно, параллельно. Отдельный главный агент проводит глубокое рассуждение через несколько итеративных раундов: на каждом раунде он рассылает вопрос всем субагентам, собирает то, что они нашли, и на основе уже найденного формулирует более глубокий уточняющий вопрос. Вся обучаемая часть системы сосредоточена в главном агенте, именно его дообучают с помощью обучения с подкреплением, а субагенты остаются замороженными готовыми моделями без дополнительного обучения.
На многошаговых вопросно-ответных тестах (multi-hop QA) с контекстом от 7 тысяч до 896 тысяч токенов PARSER на основе модели с 4 миллиардами параметров обходит наиболее сильный из проверенных последовательных подходов в среднем на 5,7 балла, а при контексте 896 тысяч токенов разрыв растёт до 12 баллов. При увеличении основы до 9 миллиардов параметров PARSER обходит модель DeepSeek-V4-Pro на 6,3 балла. Контрольные эксперименты показали, что PARSER устойчив к перестановке, порядку и удалённости нужных фактов в документе, именно эти факторы вызывают резкие скачки точности у последовательных подходов. При этом задержка вывода снижается до 11 раз.
Ключевые факты
- PARSER разрывает связь между чтением длинного документа и глубиной рассуждения: параллельные субагенты читают фрагменты одновременно, а над находками рассуждает отдельный главный агент.
- Главный агент проходит несколько итеративных раундов, рассылает вопрос субагентам, собирает найденное и формулирует более глубокий уточняющий запрос; именно его дообучают обучением с подкреплением, субагенты остаются замороженными готовыми моделями.
- На тестах с контекстом от 7 тысяч до 896 тысяч токенов PARSER с основой на 4 млрд параметров обходит лучший из проверенных последовательных подходов на 5,7 балла в среднем и на 12 баллов при контексте 896 тысяч токенов.
- При увеличении основы до 9 млрд параметров PARSER обходит модель DeepSeek-V4-Pro на 6,3 балла.
- Архитектура устойчива к перестановке, порядку и удалённости нужных фактов в документе и снижает задержку вывода до 11 раз по сравнению с последовательными подходами.
Почему это важно
Агенты, которые обрабатывают длинные документы последовательно, кусок за куском, с компактной памятью, платят за это двумя недостатками: чувствительностью к тому, где в тексте лежит нужный факт, и ростом задержки, который линейно зависит от длины документа. Чем длиннее документ, тем дольше и менее предсказуемо агент отвечает. PARSER снимает эту связку: чтение поручено параллельным субагентам, а рассуждение, отдельному обучаемому агенту, так что скорость больше не привязана напрямую к длине текста, а качество ответа меньше зависит от того, в каком месте документа спрятан нужный факт.
Кому это важно
Это касается всех, кто строит ИИ-агентов для работы с очень длинным контекстом, многостраничными договорами, целой кодовой базой, длинными историями переписки или подшивками документов, где ответ на вопрос может зависеть от фрагментов в самом начале и в самом конце текста одновременно. Разработчикам таких систем важна не только точность, но и предсказуемая задержка: архитектура, которая не замедляется линейно с ростом документа, меняет то, какой объём текста вообще можно подавать агенту в реальной системе. Важно это и исследователям агентных архитектур: PARSER показывает, что разделение ролей, чтение отдельно, рассуждение отдельно, может одновременно поднимать точность и снижать задержку, а не быть компромиссом одного за счёт другого.
Как это применить
Практический рецепт архитектуры: часть, отвечающая за чтение, это набор лёгких субагентов, каждый закреплён за своим фрагментом документа и работает как готовая модель без дополнительного обучения. Обучать нужно только одну часть системы, главного агента, который рассылает вопросы субагентам, собирает то, что они нашли, и на основе этого формулирует более глубокий уточняющий вопрос раунд за раундом; именно его дообучают обучением с подкреплением. Такое разделение сильно снижает объём дообучения: дорого обучается только небольшая управляющая часть, а не весь конвейер чтения документа. Источник не говорит, публикуют ли авторы код или веса модели, речь идёт об архитектуре и результатах экспериментов, а не о готовом к использованию релизе.
Можно ли доверять
Цифры взяты из отчёта о контролируемых экспериментах: авторы сравнивают PARSER с конкретными базовыми подходами на одном и том же наборе многошаговых вопросно-ответных тестов и указывают точные диапазоны длины контекста и размеры моделей, такой стиль сравнения можно проверить. Слабое место, прозрачность источника: он не называет ни авторов, ни организацию, стоящую за работой, ни конкретный последовательный подход, с которым сравнивают PARSER, ни название самого бенчмарка, поэтому сверить методику сравнения не на чём, кроме заявленных чисел.
Риски и подводные камни
Улучшение проверено на контексте до 896 тысяч токенов, как архитектура ведёт себя на ещё большей длине, из текста не следует. Субагенты остаются замороженными и без обучения: качество чтения каждого фрагмента ограничено тем, что умеет базовая модель, и дообучение главного агента эту границу не поднимает. Сравнение с DeepSeek-V4-Pro относится только к варианту с основой на 9 миллиардов параметров, для варианта на 4 миллиарда источник такого сравнения не даёт. Абсолютных цифр задержки (секунд или токенов в секунду) в источнике нет, только относительное «до 11 раз», поэтому насколько быстрым получается ответ в абсолютных единицах, по статье не видно.