Open Vision Banana: открытый рецепт превращает генератор изображений в модель зрения
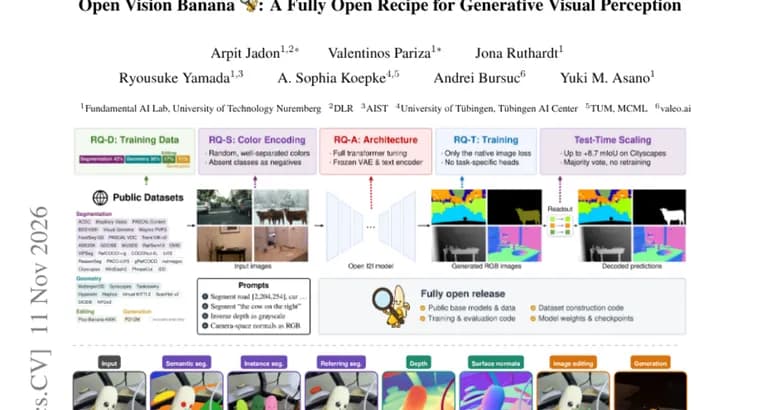
Недавние работы показывают, что предобученные генераторы изображений кодируют понимание реального мира, а не только умеют синтезировать картинки. Vision Banana использует это, формулируя задачи компьютерного зрения как условное редактирование изображения. Но, как отмечают авторы новой работы, данные, веса, код и детали реализации Vision Banana не опубликованы.
Ответ авторов, Open Vision Banana (OVB): полностью открытый и воспроизводимый рецепт превращения предобученных генераторов в единые многозадачные системы восприятия. Они стартуют с открытых базовых моделей на 4 и 9 млрд параметров и обучают их на 2,1-3,8 млн пар из публичных датасетов. Конкретные базовые модели в описании не названы.
Результаты, о которых заявляют авторы: на Cityscapes в режиме zero-shot OVB показывает 73,9 mIoU, тогда как заявленный результат Vision Banana, 69,9 mIoU. Кроме того, OVB, по словам авторов, соперничает с лучшими современными оценщиками глубины с точностью до аффинного преобразования (affine-invariant depth). Варианты OVB, которые не работают в режиме zero-shot, отстают от Vision Banana не более чем на пять пунктов в сегментации по описанию и в сегментации с рассуждением, но заметно сильнее отстают в сегментации экземпляров. Все модели в основном сохраняют исходные способности базовой модели к редактированию изображений.
Анализ авторов выделяет решения, которые сильнее всего влияют на обобщение: кодирование цвета, дизайн промптов, способ адаптации параметров и балансировка задач. Эти решения взаимодействуют: выбор, полезный сам по себе, может навредить в сочетании с другими.
Отдельный вклад, legend ensembling (ансамблирование легенд), метод масштабирования на этапе вывода для восприятия на основе генераторов. Изображение сегментируется под несколькими легендами «класс, цвет», а результаты объединяются голосованием по большинству. Это исправляет нестабильные привязки цветов к классам и без дообучения поднимает mIoU до 8,7 пункта на Cityscapes и до 15,0 пункта на COCO-Object.
Авторы публикуют конвейер построения и обработки датасета, код обучения и оценки, а также итоговые, промежуточные и абляционные чекпоинты. Есть сайт проекта: openvisionbanana.github.io.
Ключевые факты
- Open Vision Banana (OVB), полностью открытый рецепт превращения предобученных генераторов изображений в единую многозадачную систему восприятия; задачи зрения подаются как условное редактирование изображения.
- Обучение начинается с открытых базовых моделей на 4 и 9 млрд параметров и использует 2,1-3,8 млн пар из публичных датасетов.
- На Cityscapes в режиме zero-shot OVB получает 73,9 mIoU против заявленных 69,9 у Vision Banana; по глубине, по словам авторов, соперничает с лучшими оценщиками.
- Legend ensembling (сегментация под несколькими легендами «класс, цвет» и голосование по большинству) без дообучения добавляет до 8,7 пункта mIoU на Cityscapes и до 15,0 пункта на COCO-Object.
- Авторы выкладывают конвейер данных, код обучения и оценки, а также итоговые, промежуточные и абляционные чекпоинты.
Почему это важно
Идея, что генераторы изображений можно превратить в универсальные модели восприятия, уже заявлена в Vision Banana, но у той работы закрыты данные, веса, код и детали реализации. OVB делает тот же подход проверяемым: рецепт, данные и чекпоинты опубликованы, так что результат можно воспроизвести и разобрать. Авторы также показывают, какие решения определяют обобщение (кодирование цвета, дизайн промптов, адаптация параметров, балансировка задач) и что они влияют друг на друга.
Кому это важно
Исследователям компьютерного зрения, которые хотят сравнивать подходы на основе генераторов с классическими специализированными моделями. Командам, которым нужна одна модель для сегментации, оценки глубины и редактирования изображений. Тем, кто изучает масштабирование на этапе вывода: legend ensembling даёт пример такого метода для восприятия на основе генераторов.
Как это применить
Авторы публикуют конвейер построения и обработки датасета, код обучения и оценки, а также итоговые, промежуточные и абляционные чекпоинты, поэтому рецепт можно воспроизвести и взять за основу своих экспериментов. Метод стартует с открытых базовых моделей на 4 и 9 млрд параметров. Legend ensembling применяется на этапе вывода без дообучения: изображение сегментируется под несколькими легендами «класс, цвет», результаты объединяются голосованием. Подробности проекта, на сайте openvisionbanana.github.io.
Можно ли доверять
Все цифры, собственные заявления авторов. Сравнение на Cityscapes идёт с заявленным результатом Vision Banana (69,9 mIoU), а не с повторным прогоном той модели. В описании работы не названы авторы и организации, а конкретные базовые модели не указаны, только их размеры. Зато публикация кода, пайплайна данных и чекпоинтов позволяет независимо перепроверить результаты.
Риски и подводные камни
Преимущество над Vision Banana показано на Cityscapes в режиме zero-shot; варианты, не работающие в этом режиме, отстают от Vision Banana до пяти пунктов в сегментации по описанию и с рассуждением, а в сегментации экземпляров отстают сильнее. Для глубины заявлено лишь, что OVB «соперничает» с лучшими оценщиками, без числовых значений в описании. Выбранные решения взаимодействуют, поэтому переносить отдельные удачные приёмы в другую конфигурацию рискованно. Условия лицензирования кода, данных и чекпоинтов в описании не указаны, а затраты на обучение не раскрыты.