OPAL: агент переписывает код оптимизатора во время обучения
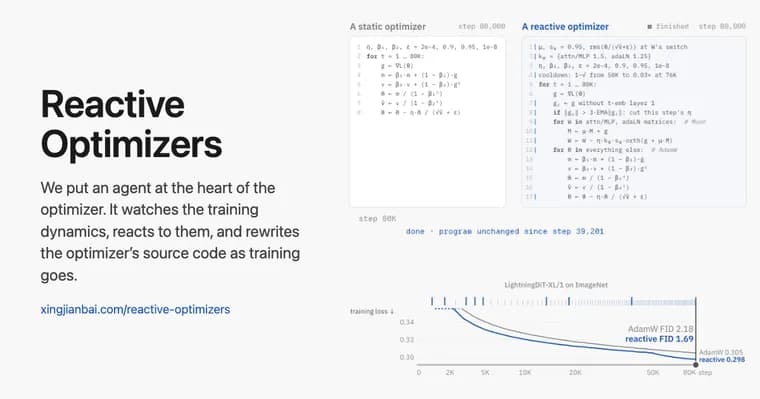
В блоге Reactive Optimizers описан «реактивный оптимизатор»: в самое сердце оптимизатора помещён ИИ-агент. Он наблюдает за динамикой обучения, реагирует на неё и переписывает исходный код оптимизатора прямо во время одного обучающего прогона. Авторы называют свою реализацию OPAL (OPtimizer with an Agent in the Loop, «оптимизатор с агентом в контуре»). Во всех показанных запусках агента обеспечивала модель Claude Opus 5.5. По утверждению авторов, когда для задачи нет настроенного рецепта, такой оптимизатор не уступает лучшему готовому рецепту или превосходит его, причём и на изображениях, и на языковых задачах.
Исходная мысль такая: сегодня рецепт оптимизации нейросети почти целиком определяется до начала обучения (адаптивные шаги, предобуславливание, ортогонализованные обновления, расписания по шагам и так далее) и дальше не меняется. Авторы спрашивают, как оптимизатору реагировать на внезапный всплеск или застой потерь, на колебания градиентов в одном модуле при ровном прогрессе в остальных, и что делать, когда новая архитектура плохо учится с Adam или Muon: сама архитектура хуже или для неё просто не нашли подходящий оптимизатор. Сценарий из текста: аспирант с одной видеокартой на сутки и ограниченным запасом токенов LLM API, у которого есть один серьёзный прогон. Реактивный оптимизатор, как пишут авторы, тратит токены LLM вместо GPU-часов и человеческого времени. Метод полностью zero-shot (без обучения на опыте): из повторных запусков ничего не запоминается и не переносится.
Механика построена на двух файлах, которые агент волен менять. Первый, updater.py, выполняется на каждом шаге оптимизации, и через него решения агента попадают в обучение. Второй, analysis.py, агент пишет сам: это его собственные диагностические «зонды», которые достают из обучения то, что агент захотел узнать (например, норму градиента каждой группы параметров, размер обновления относительно весов, косинус между соседними градиентами, тензоры с необычно большими всплесками градиентов), и передают ему для следующего решения. Сырые веса, активации и градиенты не подаются: они забили бы контекст.
Результаты. Авторы взяли задачу Track 3 из modded-nanogpt (предобучение GPT на 162M параметров на FineWeb) и сделали две вариации без настроенного рецепта: другой язык датасета (китайский, тайский, киргизский) и исходная постановка с батчем в четверть размера. Сравнивали с пятью рецептами из таблицы лидеров с естественными поправками; во всех новых постановках реактивный оптимизатор превзошёл лучший базовый вариант или сравнялся с ним. На Goldfish (350 языков, по одной небольшой GPT на датасет, стандартный рецепт без настройки под язык) на амхарском официальный рецепт даёт 83,48 бит на предложение на отложенном тексте FLORES-200 (меньше, лучше), а реактивный оптимизатор, стартовавший с этого же рецепта, за один прогон приходит к 81,11; на суахили авторы получили схожий выигрыш. Подбор скорости обучения для стандартного рецепта даёт статический вариант с 80,89, то есть лучше реактивного оптимизатора с официальным стартом, но реактивный, инициализированный от этого подобранного рецепта, снова впереди: 80,73.
В генерации изображений FID-50K на LightningDiT-XL/1 (официальный рецепт на AdamW) составил 1,83 против 2,18 с guidance и 4,33 против 5,15 без него; на RAEv2-B (рецепт с вариантом Muon) результат 3,19 против 3,39 (метрика в этой фразе не названа).
Что агент делает сам. В разделе про расписание скорости обучения авторы показывают, что расписания агентов получаются замысловатыми: отдельные многоэтапные расписания для каждой группы параметров, разные от запуска к запуску; в нескольких из них скорость обучения поднимается в середине прогона. Решения агенты опирались на собственную диагностику. Четыре примера: (1) агент SiT измерял косинус между соседними градиентами и там, где он был отрицательным, снижал скорость обучения (у эмбеддера временного шага до 0,3× и затем 0,15× от официальной), а где оставался слегка положительным у матриц Muon, повышал; (2) агент RAEv2 чередовал две скорости на отрезках в несколько сотен обновлений (A-B-A-тест) и после одного такого теста перешёл на 2× с обновления 3100; (3) он же пробовал 1,3×, вернул основу к 1×, когда её градиенты стали менять знак на каждом шаге, затем поднял все группы до 1,5×, прогнал 2×, 2,5× и 2,75× примерно по 650 обновлений каждая и оставил 2×; (4) на шаге 190K агент SiT сдвинул запланированный спад с 320K на 280K и снизил нижний порог скорости с 0,1 до 0,05 от пика, а агент RAEv2 начал спад на обновлении 11 250, то есть на 45% прогона вместо запланированных 75%, сославшись на тренд потерь и статью о затухании скорости обучения.
Заявлено также, что агент сам придумывает стратегии против всплесков потерь и выхода из переобучения, а в конце текста обещан разбор стоимости и практичности в масштабе, но видимый фрагмент статьи обрывается в середине раздела 3.1, так что эти части пересказать нельзя. Авторы ожидают, что метод будет только усиливаться с каждым поколением агентов и принесёт больше всего там, где рецепта ещё нет (новая архитектура, новый датасет); это ожидание, а не продемонстрированный результат. Попробовать на своём обучении предлагается через пакет OPAL.
Ключевые факты
- OPAL: ИИ-агент (в показанных запусках Claude Opus 5.5) наблюдает за обучением и по ходу прогона переписывает updater.py (код обновления весов на каждом шаге) и собственные диагностические зонды analysis.py.
- Метод zero-shot: из повторных запусков ничего не запоминается; по замыслу авторов, он тратит токены LLM вместо GPU-часов и человеческого времени на подбор рецепта.
- Амхарский в Goldfish: официальный рецепт 83,48 бит на предложение, реактивный оптимизатор 81,11 за один прогон; подобранный рецепт 80,89, реактивный поверх него 80,73 (меньше, лучше).
- Изображения: FID-50K на LightningDiT-XL/1 составил 1,83 против 2,18 с guidance и 4,33 против 5,15 без него; на RAEv2-B 3,19 против 3,39.
- Агенты строят разные многоэтапные расписания скорости обучения для групп параметров, включая подъём скорости в середине прогона и досрочный спад (RAEv2: на 45% прогона вместо запланированных 75%).
Почему это важно
Обычно рецепт оптимизации фиксируется до старта обучения, а подбирать его под новую архитектуру, язык или датасет дорого. Идея OPAL в том, чтобы заменить часть такого подбора вмешательством агента внутри единственного прогона: токены LLM вместо GPU-часов и человеческого времени. Если результаты, о которых пишут авторы, выдержат проверку, это интересно именно для случаев, когда готового рецепта нет. Отдельно любопытно, что агент сам пишет диагностику и сам решает, на что смотреть.
Кому это важно
Исследователям и инженерам, которые обучают модели под новые архитектуры, малоресурсные языки или нестандартные данные и не могут позволить себе большой перебор гиперпараметров. Также тем, кто изучает автоматический подбор оптимизаторов и обучение с участием LLM-агентов.
Как это применить
Авторы предлагают попробовать метод на собственном обучении через пакет OPAL; ссылки на пакет в видимой части текста нет. Практическая модель использования по тексту: один серьёзный прогон и запас токенов LLM API. Сведений о стоимости в токенах или долларах в видимой части нет: раздел о цене и практичности в масштабе в доступном фрагменте не показан.
Можно ли доверять
Это пост в блоге, и все утверждения о результатах принадлежат его авторам; в доступном тексте не названы ни авторы, ни организации. Независимой проверки или рецензии в тексте не упоминается. Не указаны число прогонов и разброс результатов, поэтому судить о значимости разницы вроде 81,11 против 80,89 нельзя. Все результаты получены с одной моделью агента, Claude Opus 5.5. Часть утверждений (про подавление всплесков потерь и выход из переобучения) опирается на разделы, которые в доступном фрагменте обрываются.
Риски и подводные камни
Отдельные выигрыши невелики: на амхарском статический подбор скорости обучения (80,89) обошёл реактивный оптимизатор со стартом от официального рецепта (81,11), и лишь совмещение двух подходов дало 80,73. Результат зависит от агента, и сравнений с другими моделями в видимом тексте нет. Агент свободно переписывает код обновления весов на каждом шаге, и это значит, что поведение обучения становится менее предсказуемым, чем у фиксированного рецепта; расписания различаются от запуска к запуску. Заявление о том, что метод усилится с новыми поколениями агентов, остаётся ожиданием авторов, а не результатом.