Omni-IO Skills: надстройка учит ИИ-агентов работать с аудио, видео и 3D
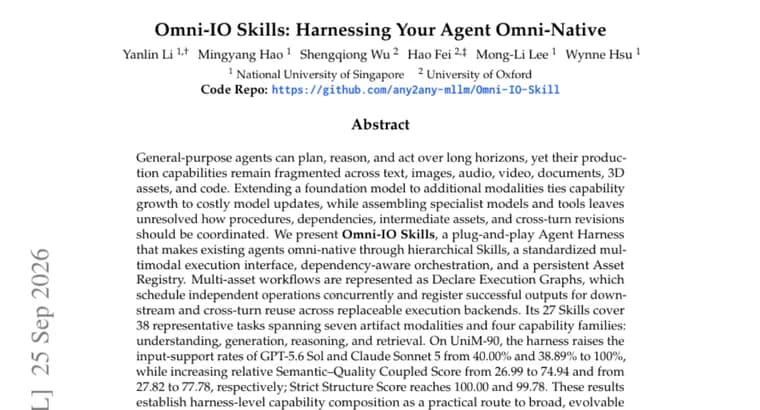
Исходная проблема, по описанию авторов: агенты общего назначения умеют планировать, рассуждать и действовать на длинном горизонте, но их возможности по созданию материалов остаются разрозненными между текстом, изображениями, аудио, видео, документами, 3D-объектами и кодом. Расширять базовую модель новыми форматами, значит привязывать рост возможностей к дорогим обновлениям модели. А если собирать набор специализированных моделей и инструментов, остаётся нерешённым вопрос, как согласовывать процедуры, зависимости, промежуточные артефакты и правки, вносимые на разных ходах диалога.
Ответ авторов, Omni-IO Skills, подключаемая надстройка (plug-and-play Agent Harness), которая делает существующих агентов «омни-нативными». Она опирается на четыре элемента: иерархические навыки (Skills), стандартизированный интерфейс мультимодального выполнения, оркестрацию с учётом зависимостей и постоянный реестр артефактов (Asset Registry).
Рабочие процессы с несколькими артефактами представлены как Declare Execution Graphs (графы декларативного выполнения). Они запускают независимые операции одновременно и регистрируют успешные результаты, чтобы их можно было повторно использовать на следующих шагах и в следующих ходах диалога; выполнять операции можно на заменяемых исполняющих бэкендах.
В набор входят 27 навыков, покрывающих 38 типовых задач в семи модальностях артефактов и четырёх семействах возможностей: понимание, генерация, рассуждение и поиск.
Результаты на бенчмарке UniM-90: надстройка подняла долю поддерживаемых входных данных у GPT-5.6 Sol с 40,00% до 100%, у Claude Sonnet 5, с 38,89% до 100%. Относительный Semantic, Quality Coupled Score вырос с 26,99 до 74,94 у GPT-5.6 Sol и с 27,82 до 77,78 у Claude Sonnet 5. Strict Structure Score достиг 100,00 и 99,78 (в порядке упоминания моделей в тексте). Авторы делают вывод, что композиция возможностей на уровне надстройки, практичный путь к широким и развиваемым омни-системам без изменения ядра рассуждений агента-хозяина.
Ключевые факты
- Omni-IO Skills, подключаемая надстройка (Agent Harness), которая делает готовых агентов омни-нативными: иерархические навыки, стандартизированный мультимодальный интерфейс, оркестрация с учётом зависимостей и постоянный реестр артефактов.
- В наборе 27 навыков на 38 типовых задач: семь модальностей артефактов и четыре семейства возможностей, понимание, генерация, рассуждение, поиск.
- На UniM-90 доля поддерживаемых входных данных выросла с 40,00% (GPT-5.6 Sol) и 38,89% (Claude Sonnet 5) до 100%.
- Относительный Semantic, Quality Coupled Score вырос с 26,99 до 74,94 у GPT-5.6 Sol и с 27,82 до 77,78 у Claude Sonnet 5; Strict Structure Score, 100,00 и 99,78.
- Многошаговые процессы описываются графами Declare Execution Graphs: независимые операции идут параллельно, удачные результаты сохраняются для повторного использования.
Почему это важно
Идея в том, чтобы наращивать мультимодальные возможности агента не дорогим обновлением самой модели, а надстройкой вокруг неё. По словам авторов, расширение базовой модели новыми форматами привязывает рост возможностей к обновлениям модели, а ручная сборка из специализированных моделей оставляет открытым вопрос координации шагов, зависимостей и промежуточных результатов. Omni-IO Skills пытается закрыть именно этот пробел на уровне оркестрации.
Кому это важно
Разработчикам агентных систем, которым нужно, чтобы один агент работал сразу с текстом, изображениями, аудио, видео, документами, 3D-объектами и кодом. Также тем, кто исследует архитектуры надстроек над языковыми моделями и способы многошаговой оркестрации.
Как это применить
Концепция подаётся как подключаемая: надстройка ставится поверх существующего агента и не меняет его ядро рассуждений. Навыки организованы иерархически, выполнение идёт через стандартизированный интерфейс, а исполняющие бэкенды можно заменять. О доступности кода, лицензии и способе подключения в тексте ничего не сказано, так что практическое внедрение по одной лишь аннотации оценить нельзя.
Можно ли доверять
Пересказ основан только на аннотации статьи; цифры приведены самими авторами. В аннотации не определены ни Semantic, Quality Coupled Score, ни Strict Structure Score, ни то, относительно чего считается «относительный» показатель, не объяснено, что такое UniM-90 (помимо названия), и не приведено сравнений с другими надстройками или конвейерами специализированных моделей. Рост с 40% до 100% по поддержке входных данных нагляден, но без описания бенчмарка его трудно интерпретировать. Вывод о «практичном пути», заключение самих авторов.
Риски и подводные камни
Результаты получены на одном бенчмарке (UniM-90) и двух агентах-хозяевах. Сведений о задержке, стоимости и вычислительных затратах в тексте нет, поэтому неизвестно, чего стоит оркестрация. Поскольку метрики не определены, а сравнения с другими подходами отсутствуют, заявленный рост лучше считать предварительным, пока не проверен по полной статье и независимыми замерами.