Новый метод OPRD научил модель превосходить слабого учителя
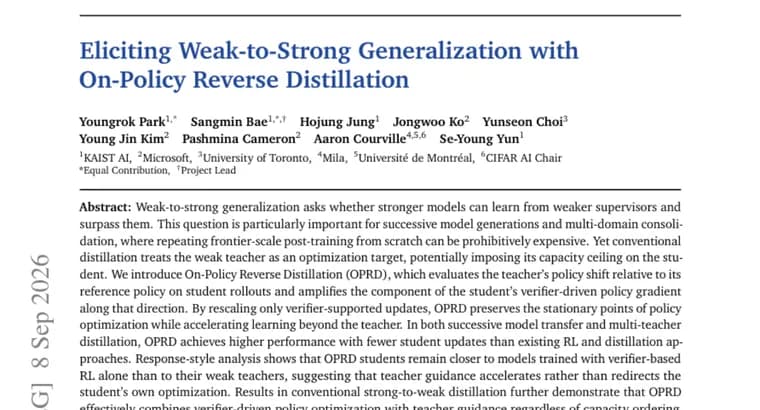
Обобщение «от слабого к сильному» (weak-to-strong generalization), это вопрос о том, могут ли более сильные модели учиться у более слабых учителей и в итоге превосходить их. Он особенно важен для последовательных поколений моделей и для объединения возможностей из разных предметных областей: заново повторять дорогостоящее дообучение модели самого высокого уровня с нуля для каждого следующего поколения или домена может быть непомерно дорого. Однако, как отмечают авторы, классическая дистилляция знаний обращается со слабым учителем как с прямой целью оптимизации ученика, а значит потенциально навязывает ученику тот же потолок возможностей, что есть у самого учителя.
Авторы предлагают метод под названием On-Policy Reverse Distillation, или OPRD (дословно, «обратная дистилляция по действующей политике»). Он сравнивает, как политика учителя смещается относительно собственной опорной (референсной) политики, но делает это на траекториях, сгенерированных самим учеником, а не учителем. Затем OPRD усиливает ту часть градиента политики ученика, которая опирается на сигнал верификатора (проверяющего компонента, оценивающего правильность ответа) и при этом совпадает по направлению с этим сдвигом учителя. Поскольку пересчитываются только обновления, уже подтверждённые верификатором, метод не сдвигает стационарные точки, то есть состояния, к которым сходится обучение, при этом ускоряя обучение ученика за пределы возможностей самого учителя.
В экспериментах и с последовательной передачей возможностей между поколениями моделей, и с дистилляцией сразу от нескольких учителей OPRD, по данным авторов, достигает более высокого качества при меньшем числе обновлений ученика, чем существующие методы обучения с подкреплением и дистилляции, конкретных цифр (точность, число обновлений) в тексте не приводится. Отдельный анализ стиля ответов показывает, что модели, обученные OPRD, по стилю оказываются ближе к моделям, обученным одним лишь обучением с подкреплением на сигнале верификатора, чем к своим слабым учителям; авторы интерпретируют это как признак того, что учитель ускоряет собственную оптимизацию ученика, а не переопределяет её направление. Наконец, эксперименты в обратной, классической постановке, дистилляция от сильного учителя к слабому ученику, показывают, что OPRD одинаково успешно сочетает оптимизацию по сигналу верификатора с ориентацией на учителя независимо от того, кто из двух, учитель или ученик, обладает большей «мощностью».
В самой аннотации нет ни одной конкретной цифры, ни точности, ни результатов на бенчмарках, ни величины прироста в процентах или пунктах: улучшения описаны только качественно, словами «выше качество» и «меньше обновлений». Не названы ни имена всех авторов и их институциональная принадлежность (кроме Ёнрок Пак (Youngrok Park), указанного как один из авторов на странице HuggingFace), ни конкретные семейства и размеры моделей, ни используемые бенчмарки или датасеты. Ничего не сказано о публикации кода или весов модели, не указана дата публикации, и не определено, где именно проходит граница между «слабой» и «сильной» моделью.
Ключевые факты
- OPRD (On-Policy Reverse Distillation), новый метод, который снимает главное ограничение классической дистилляции: ученик перестаёт упираться в потолок возможностей слабого учителя и может его превзойти.
- Механизм: метод сравнивает смещение политики учителя относительно её опорной версии на траекториях самого ученика и усиливает ту часть градиента политики ученика (основанного на сигнале верификатора), которая совпадает с этим смещением.
- Поскольку пересчитываются только уже подтверждённые верификатором обновления, OPRD не меняет конечные точки обучения (стационарные точки), а лишь ускоряет его, так ученик обучается быстрее и превосходит учителя.
- По данным авторов, в экспериментах и с последовательной передачей между поколениями моделей, и с дистилляцией от нескольких учителей сразу OPRD достигает более высокого качества при меньшем числе обновлений ученика, чем существующие методы обучения с подкреплением и дистилляции; точных цифр в тексте нет.
- Модели, обученные OPRD, по стилю ответов ближе к моделям, обученным одним обучением с подкреплением на основе верификатора, чем к своим слабым учителям, то есть учитель, по мнению авторов, ускоряет обучение ученика, а не переопределяет его; метод также работает и в обратную сторону, при классической дистилляции от сильного учителя к слабому ученику.
Почему это важно
Классическая дистилляция знаний превращает слабого учителя в прямую цель оптимизации для ученика, из-за этого ученик, по сути, не может выйти за рамки возможностей самого учителя. Это особенно неудобно там, где повторять дорогостоящее дообучение модели с нуля для каждого следующего поколения или для объединения знаний из разных предметных областей может быть непомерно дорого. OPRD снимает это ограничение: метод усиливает только ту часть собственного, основанного на верификаторе градиента ученика, которая совпадает с направлением смещения политики учителя, и не трогает остальное. За счёт этого, по данным авторов, ученик обучается быстрее и в итоге способен превзойти учителя, а не просто повторить его с потерями, как это происходит при обычной дистилляции.
Кому это важно
В первую очередь, исследователям и инженерам, которые строят конвейеры последовательного обучения моделей: каждое новое поколение можно бутстрапить от предыдущего, не повторяя дорогостоящее дообучение с нуля. Полезен метод и тем, кто объединяет знания из нескольких предметных областей через нескольких учителей сразу (multi-teacher distillation), а также разработчикам методов обучения с подкреплением для задач с проверяемым правильным ответом, там, где обучение опирается на верификатор (математика, код, другие задачи с автоматической проверкой). Конечным пользователям готовых продуктов результат пока не пригодится: это исследовательская статья про метод обучения, а не выпущенный инструмент или модель.
Как это применить
В тексте не сказано, опубликованы ли код или веса моделей, судить по одной аннотации, что именно можно взять и повторить, нельзя. Сам принцип, однако, описан достаточно конкретно: нужна связка «слабый учитель + ученик + верификатор», где обучение ученика идёт через обучение с подкреплением с проверяемым сигналом о правильности ответа. OPRD оценивает смещение политики учителя относительно его опорной версии на траекториях самого ученика, а затем усиливает ту часть подтверждённого верификатором градиента ученика, которая направлена так же, как это смещение, без изменения остальной части обучения. Конкретные модели, размеры и бенчмарки, на которых это проверялось, в аннотации не названы.
Можно ли доверять
Это препринт, опубликованный на HuggingFace Papers, 84 отметки и 2 комментария в обсуждении на момент публикации; независимого аудита или воспроизведения третьей стороной не упоминается. Один из авторов, Ёнрок Пак (Youngrok Park); полный список соавторов и их институциональная принадлежность в самой аннотации не указаны. Главное ограничение для доверия, в тексте нет ни одной количественной цифры: утверждения о «более высоком качестве» и «меньшем числе обновлений» качественные, без конкретных значений точности, бенчмарков или величины прироста. Дата публикации работы в тексте тоже не приведена.
Риски и подводные камни
Все результаты в аннотации описаны только словами, без единой цифры, оценить размер выигрыша или сравнить его с другими методами по существу нельзя. Не названы ни конкретные модели и их размеры, ни бенчмарки и датасеты, на которых проверяли метод, неясно, в каком классе задач и при каком разрыве между «слабым» и «сильным» результат воспроизводится: чёткой границы между этими понятиями в тексте тоже нет. О публикации кода или весов моделей ничего не сказано, так что независимо проверить заявленные преимущества по одной аннотации нельзя. Сам механизм метода завязан на верификатор, то есть на задачи с автоматически проверяемым правильным ответом; применим ли OPRD к задачам без такой проверки, из текста не следует.