Новая техника обучения MoE сняла пики памяти и разогнала контекст до 1 млн токенов
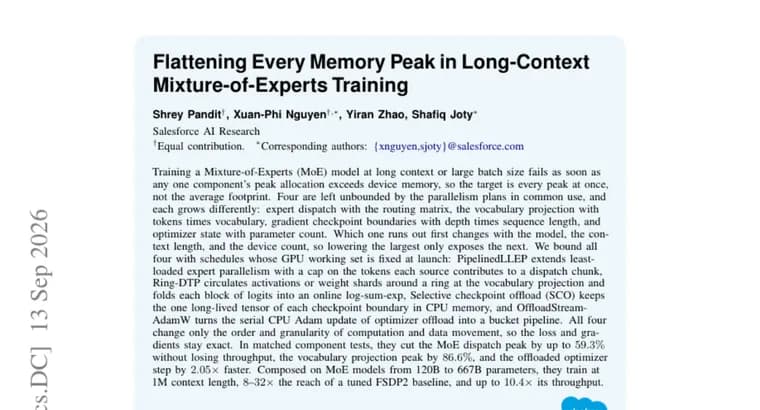
Обучение Mixture-of-Experts (MoE) моделей на длинном контексте или большом батче упирается не в среднюю нагрузку на память, а в пиковую: обучение падает, как только пиковое потребление памяти хотя бы одного компонента превышает объём памяти устройства. Авторы указывают, что применяемые сейчас схемы параллелизма оставляют без ограничения сразу четыре компонента, и каждый растёт по-своему: диспетчеризация экспертов вместе с матрицей маршрутизации, проекция словаря (произведение числа токенов на размер словаря), границы чекпоинтов градиента (произведение глубины сети на длину последовательности) и состояние оптимизатора (объём, пропорциональный числу параметров). То, какой из этих четырёх компонентов упирается в память первым, зависит от модели, длины контекста и числа устройств, поэтому снижение текущего наибольшего пика лишь выявляет следующий.
Чтобы решить проблему сразу для всех четырёх компонентов, авторы предложили четыре схемы, каждая из которых фиксирует объём рабочей памяти GPU уже на старте обучения. PipelinedLLEP расширяет параллелизм экспертов по принципу «наименее загруженный» ограничением на число токенов, которые каждый источник передаёт в один фрагмент диспетчеризации. Ring-DTP прогоняет активации или фрагменты весов по кольцу на этапе проекции словаря и сворачивает каждый блок логитов через потоковый (онлайновый) log-sum-exp. SCO (Selective checkpoint offload, выборочная выгрузка чекпоинтов) держит один самый «долгоживущий» тензор каждой границы чекпоинта в памяти CPU, а не GPU. OffloadStreamAdamW превращает последовательное обновление оптимизатора Adam на CPU при выгрузке состояния в конвейер из пакетов (буферов). Все четыре схемы меняют только порядок и степень детализации вычислений и перемещения данных, значение функции потерь и градиенты остаются точными, без приближений.
В изолированных (matched component) тестах по отдельным компонентам это дало: пик памяти диспетчеризации MoE снижен до 59,3% без потери производительности, пик памяти проекции словаря, на 86,6%, а шаг оптимизатора при выгрузке состояния ускорен в 2,05 раза. При совместном применении всех четырёх схем на MoE-моделях от 120 до 667 миллиардов параметров модели обучаются на контексте длиной 1 миллион токенов, это в 8, 32 раза больше охвата настроенного базового решения на FSDP2, и с производительностью, которая выше этого базового решения до 10,4 раза.
Ключевые факты
- Четыре компонента обучения MoE-моделей (диспетчеризация экспертов, проекция словаря, чекпоинты градиента, состояние оптимизатора) имеют независимые, никем не ограниченные пики памяти, снижение одного лишь выявляет следующий
- Четыре новые схемы (PipelinedLLEP, Ring-DTP, SCO, OffloadStreamAdamW) фиксируют объём рабочей памяти GPU на старте обучения, не меняя значение функции потерь и градиенты
- В отдельных тестах: пик памяти диспетчеризации экспертов снижен до 59,3%, пик проекции словаря, на 86,6%, шаг оптимизатора ускорен в 2,05 раза
- При совместном применении на MoE-моделях от 120 до 667 млрд параметров достигнут контекст в 1 млн токенов, в 8, 32 раза больше охвата настроенного базового решения на FSDP2
- Производительность при этом выросла до 10,4 раза по сравнению с тем же базовым решением на FSDP2
Почему это важно
Обучение MoE-моделей на длинном контексте до сих пор упирается не в среднюю нагрузку на память GPU, а в пиковую: обучение обрывается, как только пиковое потребление памяти хотя бы одного из четырёх независимых компонентов (диспетчеризация экспертов, проекция словаря, чекпоинты градиента, состояние оптимизатора) превышает объём памяти устройства. Снижение текущего наибольшего пика раньше лишь переносило проблему на следующий компонент, тот, что рос быстрее всех. Предложенные четыре схемы впервые фиксируют рабочий объём памяти GPU для всех четырёх компонентов сразу и заранее, на старте обучения.
Кому это важно
Команды, которые обучают крупные MoE-модели (в тестах, от 120 до 667 миллиардов параметров) на длинном контексте или большом размере батча и упираются в объём памяти GPU при масштабировании. Также значимо для тех, кто настраивает параллелизм обучения (expert parallelism, выгрузку состояния оптимизатора, чекпоинтинг градиента) и ищет способ довести контекст до значений порядка миллиона токенов без покупки дополнительного оборудования.
Как это применить
Все четыре схемы, PipelinedLLEP, Ring-DTP, SCO (выборочная выгрузка чекпоинтов на CPU) и OffloadStreamAdamW (конвейерное обновление Adam при выгрузке оптимизатора), меняют только порядок и степень детализации вычислений и перемещения данных между GPU и CPU, а не саму математику обучения: значение функции потерь и градиенты остаются точными, без приближений. Их можно комбинировать друг с другом при обучении MoE-моделей, где заранее известен потолок памяти GPU и нужно предсказуемо зафиксировать этот потолок ещё до запуска обучения. Источник не сообщает, опубликован ли код или веса моделей.
Можно ли доверять
Цифры взяты из собственных тестов авторов: сначала, изолированные (matched component) измерения по каждому из четырёх компонентов отдельно, затем, совместный результат на MoE-моделях от 120 до 667 миллиардов параметров при сравнении с одним и тем же базовым решением, настроенным (tuned) FSDP2. Других базовых решений для сравнения в тексте не названо. Сам текст источника не называет ни авторов, ни организацию, ни конкретное железо (модель GPU, размер кластера), ни дату публикации или площадку, это данные страницы Hugging Face Papers, а не сведения из текста статьи.
Риски и подводные камни
Все приведённые проценты и разы, из тестов самих авторов, без независимой проверки третьей стороной; сравнение приведено только с одним базовым решением (настроенный FSDP2), а не с другими схемами параллелизма или выгрузки. Источник не указывает, на каком именно оборудовании получены цифры, и не сообщает, доступны ли код или веса моделей для воспроизведения результатов.