Multiverse Computing представила ProvenanceGuard: проверку источника факта в ответах ИИ-агентов
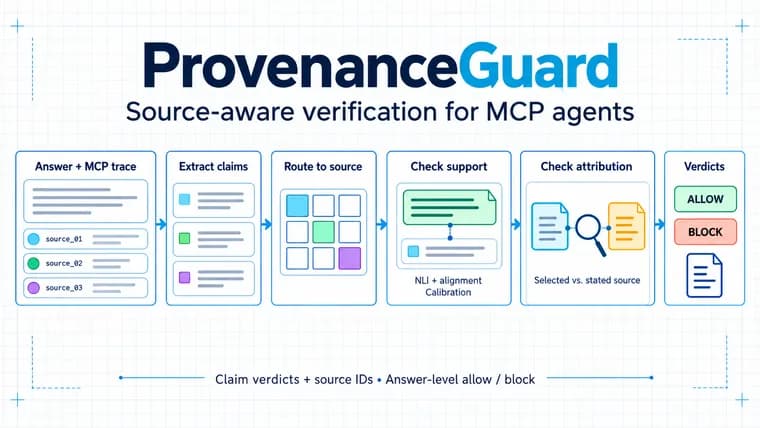
Команда Multiverse Computing опубликовала в блоге на Hugging Face разбор своей статьи ProvenanceGuard: Source-Aware Factuality Verification for MCP-Based LLM Agents. Речь о сбое, который авторы называют «перекрёстным смешением источников» (cross-source conflation): утверждение где-то в собранных материалах верно, но ответ приписывает его не тому источнику. Проверка, которая смотрит на все данные как на один общий пул, такое утверждение пропустит, поскольку факт в пуле есть. Пример из блога: агент поддержки пишет «согласно записи об аккаунте, тариф включает 30-дневный срок возврата денег», а на деле это условие стоит в документе с политикой, а не в записи об аккаунте. В клиническом агенте так же опасно, когда деталь о лекарстве конкретного пациента из его истории болезни подаётся как вывод медицинской литературы.
ProvenanceGuard, слой проверки, который работает после генерации ответа поверх агента-«чёрного ящика» на основе MCP. Он читает записанный журнал вызовов (MCP-трейс) вместе с выводами инструментов и идентификаторами источников и не требует дообучения агента. Дальше он по шагам разбивает ответ на отдельные утверждения, находит для каждого наиболее подходящий источник, проверяет, подтверждает ли этот источник утверждение, сравнивает его с источником, который ответ называет или подразумевает, и выдаёт вердикт по каждому утверждению плюс общее решение по ответу: пропустить или заблокировать. Заблокированный ответ может пройти ремонт в стиле RARR (пересборка на основе источников или безопасная заглушка) и проверяться заново. В экспериментах использовали локальные модели: MiniLM для поиска источника, NLI-модель DeBERTa для проверки подтверждения и локальную языковую модель для разбиения ответа на утверждения. Числа, даты и идентификаторы, которых нет в источнике, не проходят только из-за правдоподобной формулировки. Авторы подчёркивают, что эти модели, оцениваемая конфигурация, а не требование: шаги можно перенести на облачные модели, но новой конфигурации понадобятся собственные тесты и калибровка.
Результаты. Тестировали на ответах медицинского агента, который пользовался записями пациентов, научными статьями и другими инструментами: было доступно 281 реальный трейс. В основном тесте эксперты-люди проверили 361 утверждение из 40 ответов, отложенных от данных, на которых разрабатывали систему. Эксперты сочли 139 утверждений непроходными, ProvenanceGuard поймал 138 и пропустил одно. Ещё 67 утверждений, которые эксперты считали подтверждёнными, система задержала и отправила на проверку или ремонт: политика осторожная и предпочитает лишний раз перепроверить, чем пропустить неподтверждённое. Для утверждений с определимым источником правильный источник выбран примерно в 86% случаев. Четыре других проверщика подтверждения на тех же утверждениях уступили ProvenanceGuard по метрике, которая учитывает и поимку утверждений на блокировку, и отсутствие лишних блокировок; кроме того, они не указывали, какой вывод инструмента подтверждает утверждение.
В отдельном более трудном тесте с несколькими похожими источниками ProvenanceGuard показал F1 0,846 на решении о блокировке, но точный источник определил верно лишь в 50,3% утверждений; авторы называют различение похожих источников областью для улучшения. В контролируемом тесте на неверную атрибуцию в 50 случаях заменили названный источник, оставив подтверждающие данные нетронутыми, и система поймала все 50 подмен.
Ремонт. В прогоне по полным трейсам с петлёй ремонта разрешились все 173 заблокированных ответа, но 144 из них закончились текстом-заглушкой, а не содержательной переписью: по словам авторов, система предпочитает не выдавать непроверяемый ответ. На восстановленных многоисточниковых трейсах новый прогон ремонта разрешил все 59 изначально заблокированных ответов, лишь два закончились заглушкой. Накладные расходы в офлайн-режиме на описанной локальной конфигурации, около полусекунды на ответ, сами вызовы NLI и подбора источника занимают десятки миллисекунд.
Авторы пишут, что подход применим и в других областях, если агент сохраняет журнал выводов инструментов и идентификаторов источников. В качестве примера называют NVIDIA NVFlow, где влит необязательный этап проверки обоснованности ответов финансового агента: он сверяет готовые ответы с выдержками из документов SEC, которые агент получил, и сохраняет отдельные решения, не меняя исходные прогоны и обучающие данные. Там используется подход ProvenanceGuard к проверке с учётом источника; петля ремонта относится к более широкой исследовательской системе. Также работа представлена постером на Agentic AI Summit 2026 в UC Berkeley.
Ключевые факты
- ProvenanceGuard, слой проверки после генерации для агентов-«чёрных ящиков» на MCP: разбивает ответ на утверждения, ищет источник каждого и сравнивает с названным в ответе; агента дообучать не нужно.
- На тесте с медицинским агентом (361 утверждение из 40 ответов, проверенных экспертами) система поймала 138 из 139 непроходных утверждений, но задержала и 67 утверждений, которые эксперты считали подтверждёнными; правильный источник выбран примерно в 86% случаев.
- В более трудном тесте с похожими источниками F1 по решению о блокировке составил 0,846, но точный источник определён верно лишь в 50,3% утверждений; все 50 искусственных подмен источника пойманы.
- В петле ремонта разрешены все 173 заблокированных ответа, но 144 закончились текстом-заглушкой; накладные расходы, около полусекунды на ответ на локальной конфигурации.
- Авторы сообщают, что подход уже применён в NVIDIA NVFlow: там влит необязательный этап проверки обоснованности ответов финансового агента.
Почему это важно
Обычные проверки достоверности смотрят, есть ли утверждение где-то в собранных данных. Для агентов с несколькими инструментами этого мало: факт может быть верным, но приписанным не тому источнику, например данным пациента вместо медицинской литературы. Авторы утверждают, что в чувствительных сферах неверная атрибуция бывает так же вредна, как неверный факт. ProvenanceGuard делает связь «утверждение, источник» видимой для проверяющего человека.
Кому это важно
Командам, которые строят агентов на MCP и работают с данными, где важно, откуда взята информация: медицина, поддержка клиентов, финансы. Также тем, кто оценивает надёжность агентов и ищет способ проверять уже готовые системы без дообучения.
Как это применить
По описанию авторов, слой работает поверх записанного трейса агента: нужны выводы инструментов и идентификаторы источников. В работе использованы локальные модели (MiniLM, DeBERTa NLI и локальная языковая модель для разбиения на утверждения), которые можно заменить облачными, но тогда понадобятся собственные тесты и калибровка. В тексте не сказано, что инструмент выпущен как открытый код или как продукт; для подробностей авторы отсылают к полной статье или к обращению в их команду.
Можно ли доверять
Источник, блог самих авторов, то есть материал самопрезентации без независимой проверки. Основные результаты получены на одном медицинском агенте, и для других областей авторы своих измерений не приводят; для NVFlow метрик нет. Для четырёх сравниваемых проверщиков в тексте не названы ни имена, ни числовые оценки, а F1 в основном тесте не указан. Часть цифр (86% выбора источника, 138 из 139) относится к небольшой выборке из 40 ответов.
Риски и подводные камни
Осторожная политика даёт лишние блокировки: 67 утверждений, которые эксперты считали подтверждёнными, были задержаны. В трудном тесте с похожими источниками точный источник определён верно лишь в 50,3% случаев. Из 173 заблокированных ответов в ремонте 144 закончились текстом-заглушкой, а не содержательной переписью. Результаты получены на локальной конфигурации; при переходе на облачные модели нужна повторная калибровка.
«Сбой, который нас интересует, мы называем перекрёстным смешением источников: утверждение верно где-то в материалах, но приписано не тому источнику.»
— Команда Multiverse Computing, блог на Hugging Face