Мультимодальным моделям не нужен предобученный визуальный энкодер, но нужны отдельные зрительные параметры
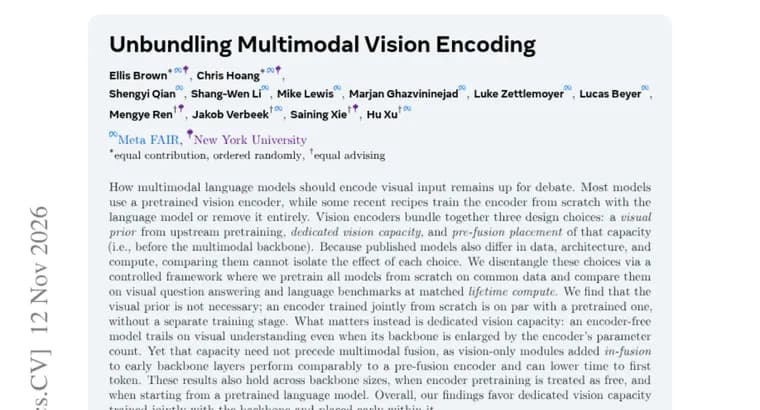
Как мультимодальная языковая модель должна кодировать изображения, до сих пор спорно. Большинство моделей используют предобученный визуальный энкодер, а часть недавних рецептов обучает энкодер с нуля вместе с языковой моделью или вовсе убирает его. В статье, представленной на Hugging Face Papers, разбирается, что именно в визуальном энкодере важно.
Авторы замечают, что энкодер объединяет три отдельных проектных решения: визуальный приор (знания, полученные при предварительном обучении вне мультимодальной модели), выделенную зрительную ёмкость (параметры, отведённые под обработку изображений) и её размещение до слияния модальностей, то есть перед основной мультимодальной сетью. Сравнивать опубликованные модели напрямую нельзя: они различаются данными, архитектурой и вычислительными затратами, поэтому эффект каждого решения по отдельности не выделить.
Чтобы это обойти, авторы строят контролируемую постановку: все модели предобучаются с нуля на общих данных и сравниваются на бенчмарках по визуальным вопросам и ответам и на языковых бенчмарках при равном суммарном вычислительном бюджете.
Результаты таковы. Во-первых, визуальный приор не нужен: энкодер, обученный с нуля совместно с моделью, не уступает предобученному, и отдельный этап обучения не требуется. Во-вторых, важна именно выделенная зрительная ёмкость: модель без энкодера отстаёт в понимании изображений, даже если увеличить её основную сеть на число параметров энкодера. В-третьих, эта ёмкость не обязана стоять до слияния: чисто зрительные модули, добавленные внутрь ранних слоёв основной сети, работают сопоставимо с энкодером до слияния и могут сократить время до первого токена.
Авторы сообщают, что выводы сохраняются при разных размерах основной сети, при условии, что предобучение энкодера считается бесплатным, и при старте от предобученной языковой модели. Итог: результаты говорят в пользу выделенной зрительной ёмкости, обучаемой совместно с основной сетью и размещаемой в ней на раннем этапе.
Ключевые факты
- Визуальный энкодер объединяет три решения: визуальный приор от предобучения, выделенную зрительную ёмкость и её размещение до слияния модальностей.
- Все модели предобучены с нуля на общих данных и сравнены на бенчмарках по визуальным вопросам и ответам и на языковых бенчмарках при равном суммарном вычислительном бюджете.
- Приор не обязателен: энкодер, обученный с нуля совместно с моделью, не уступает предобученному, и отдельный этап обучения не нужен.
- Модель без энкодера отстаёт в понимании изображений, даже если основную сеть увеличили на число параметров энкодера.
- Зрительные модули внутри ранних слоёв основной сети работают сопоставимо с энкодером до слияния и могут сократить время до первого токена.
Почему это важно
Предобученный визуальный энкодер давно служит стандартной частью мультимодальных моделей, но часть недавних рецептов обучает его с нуля или убирает совсем. Прямое сравнение таких моделей ничего не доказывает, потому что у них разные данные, архитектура и вычислительные затраты. Работа делает именно сравнение в одинаковых условиях и разводит три решения, которые обычно идут одним пакетом. Вывод двойной: отдельный предобученный энкодер не обязателен, но и полностью отказаться от зрительных параметров нельзя.
Кому это важно
Прежде всего тем, кто проектирует и обучает мультимодальные языковые модели: выбор между готовым энкодером, энкодером с нуля и схемой без энкодера напрямую влияет на этапы обучения и на устройство модели. Отдельный интерес для тех, кого волнует задержка при выводе: в аннотации сказано, что зрительные модули внутри ранних слоёв могут снизить время до первого токена.
Как это применить
Аннотация не даёт готового рецепта с конкретными числами, но направление ясно. Отдельный этап предобучения энкодера можно не считать обязательным: совместное обучение с нуля даёт сопоставимое качество. Экономить на зрительных параметрах не стоит: увеличение основной сети на размер энкодера отставание модели без энкодера не устранило. Размещать зрительную ёмкость можно не только перед основной сетью, но и внутри её ранних слоёв, что может сократить время до первого токена. Перед применением стоит свериться с полным текстом статьи.
Можно ли доверять
Это пересказ аннотации статьи, все выводы принадлежат её авторам. Сильная сторона постановки в том, что все модели обучены с нуля на общих данных и сравниваются при равном суммарном вычислительном бюджете. Авторы также сообщают, что результаты устойчивы при разных размерах основной сети и при старте от предобученной языковой модели. Но в тексте аннотации нет названий моделей и бенчмарков, баллов и величины сокращения времени до первого токена, поэтому силу эффектов по аннотации оценить нельзя.
Риски и подводные камни
Формулировки аннотации осторожные: зрительные модули внутри ранних слоёв работают «сопоставимо» с энкодером до слияния и «могут» снизить время до первого токена, то есть выигрыш в скорости не гарантирован. Вывод, что приор не нужен, получен в контролируемой постановке с обучением с нуля на общих данных. Авторы отдельно проверяют случай, когда предобучение энкодера считается бесплатным, и случай старта от предобученной языковой модели, но переносить результат на любые другие условия обучения без проверки не стоит.
«В целом наши результаты говорят в пользу выделенной зрительной ёмкости, обучаемой совместно с основной сетью и размещаемой в ней на раннем этапе.»
— Из аннотации статьи «Unbundling Multimodal Vision Encoding»