Модель π^4 восстанавливает геометрию и движение 4D-сцены по обычным кадрам
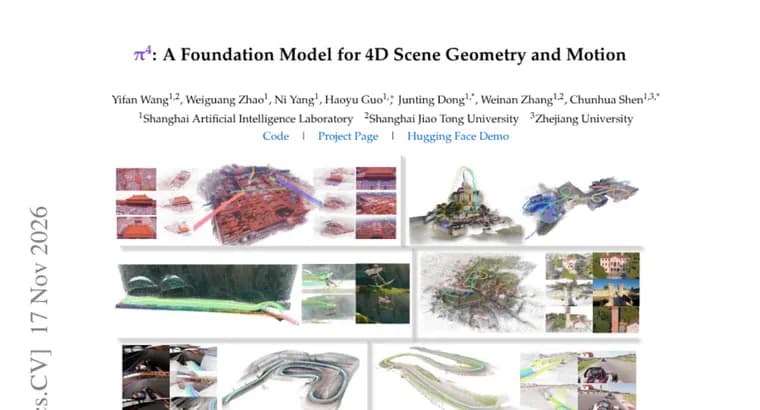
В статье представлена π^4, единая базовая модель (foundation model) для восприятия 4D-сцен, то есть трёхмерной геометрии вместе с её изменением во времени. Входом служат произвольные некалиброванные RGB-кадры «из реального мира»: одно изображение, неупорядоченный набор снимков или видеопоследовательность.
Из такого входа модель восстанавливает плотную геометрию, позы камер и метрический масштаб. Если на входе несколько изображений, она дополнительно выдаёт 2D- и 3D-треки точек и маски движущихся объектов.
Архитектура связывает две ветви: геометрическую и ветвь движения, зависящую от геометрии (geometry-conditioned motion branch). Вторая предсказывает соответствия в плоскости изображения, которые затем поднимаются в 3D с помощью восстановленной геометрии целевого вида.
По заявлению авторов, на разнообразных бенчмарках π^4 показывает лучший общий средний ранг в оценке геометрии. В отслеживании точек (одиночные и множественные виды, 2D и 3D) и сегментации движущихся объектов результат описан как конкурентный, то есть не обязательно лучший. Названия бенчмарков и конкретные значения метрик в тексте не приведены.
Полная система с общим backbone (базовой сетью) содержит примерно 0,5 млрд параметров, менее половины размера большинства базовых методов, с которыми сравнивали. Модель выдаёт совместные реконструкции и треки за один прямой проход, включая крупные сцены из тысяч входных изображений, хотя обучалась на контекстах не более чем из 64 видов.
Авторы также описывают данные и рецепт обучения, лежащие в основе этих возможностей, и приводят эмпирические исследования ключевых проектных решений. Код и модели опубликованы на GitHub (github.com/yyfz/Pi4).
Ключевые факты
- π^4, единая модель 4D-восприятия: по одному изображению, набору снимков или видео без калибровки восстанавливает плотную геометрию, позы камер и метрический масштаб.
- Для нескольких изображений добавляются 2D/3D-треки точек и маски движущихся объектов; всё выдаётся за один прямой проход.
- Лучший общий средний ранг заявлен только для оценки геометрии; в трекинге точек и сегментации движущихся объектов результат назван конкурентным.
- Около 0,5 млрд параметров, меньше половины размера большинства базовых методов; обучение на контекстах до 64 видов, а на выводе обрабатываются сцены из тысяч изображений.
- Код и модели опубликованы на GitHub, в статье также описаны данные и рецепт обучения.
Почему это важно
Обычно геометрия сцены, позы камер, отслеживание точек и поиск движущихся объектов решаются разными моделями. π^4 объединяет их в одну систему, которая работает с неподготовленными данными, без калибровки камеры и в том числе с одиночным кадром. Заявленная компактность (около 0,5 млрд параметров при размере менее половины большинства базовых методов) делает подход практичнее, если результаты подтвердятся независимыми проверками.
Кому это важно
Исследователям компьютерного зрения и 3D-реконструкции, робототехникам и разработчикам, которым нужны геометрия сцены, траектории камеры и маски движущихся объектов из обычного видео или набора фотографий. Тем, кто собирает конвейеры из отдельных моделей для геометрии и трекинга, стоит посмотреть на единый вариант.
Как это применить
Код и модели опубликованы на GitHub (github.com/yyfz/Pi4), поэтому результаты можно проверить на собственных данных: подать одно изображение, набор снимков или видео и получить геометрию, позы камер и метрический масштаб. Для нескольких изображений доступны ещё треки точек и маски движущихся объектов. Лицензия в тексте аннотации не указана, перед использованием в проектах её нужно посмотреть в репозитории.
Можно ли доверять
Все утверждения, самооценка авторов из аннотации к статье. Цифр, названий бенчмарков и конкурирующих методов в тексте нет, поэтому степень превосходства проверить по нему нельзя. Лучший ранг заявлен только для геометрии; для трекинга и сегментации сказано лишь «конкурентно». Тот факт, что код и модели открыты, позволяет независимо воспроизвести результаты.
Риски и подводные камни
Заявление «лучший общий средний ранг» зависит от выбора бенчмарков и методов сравнения, которые в аннотации не перечислены. Модель обучалась на контекстах не более 64 видов; работа со сценами из тысяч изображений заявлена, но точных чисел и показателей качества на таких масштабах в тексте нет. Данных о скорости вывода и затратах на вычисления тоже нет, поэтому практическую стоимость запуска придётся оценивать самостоятельно.