Мировая модель WARC учит новые механики игр ARC-AGI-3 на лету
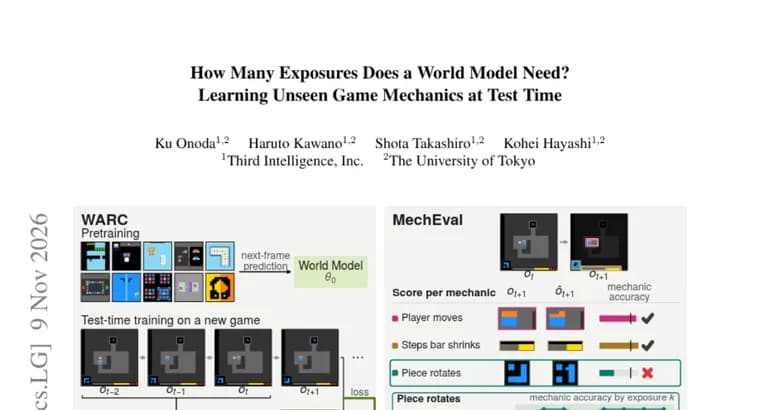
Мировые модели (world models) позволяют агентам планировать и учиться на воображаемом опыте, но в незнакомой среде им приходится осваивать её механики по ограниченному взаимодействию. Авторы препринта определяют механику как правило, по которому действие или взаимодействие меняет часть среды, а каждое наблюдаемое моделью появление механики считают одним «воздействием» (exposure). Вопрос работы: сколько таких воздействий нужно мировой модели, чтобы предсказывать эффекты механик новой среды.
Исследование проведено на ARC-AGI-3, наборе интерактивных игр, заданных их программами. Авторы вводят оценку MechEval: по программам игр она размечает 69 повторяющихся механик в 20 играх и оценивает каждое предсказание по тем клеткам, которые механика меняет при каждом воздействии. Как испытательный стенд они строят WARC (World model for ARC-AGI-3), визуальный трансформер (vision transformer) на 35 млн параметров, предварительно обученный на других играх и обновляющий все свои параметры после каждого перехода.
На отложенных (не виденных при обучении) играх WARC учится предсказывать четыре механики из пяти с точностью не ниже 80% на изменяемых ими клетках и сохраняет эту точность до конца записей. Половина из них достигает такой точности примерно за 80 воздействий, то есть за одно прохождение игры. Без обновления параметров во время теста этой точности вообще достигает лишь одна механика из семи.
В замкнутом цикле игры на публичных играх агент WARC-Agent, который сочетает WARC с фиксированным исследователем на основе графа (graph explorer), втрое повышает официальную оценку эффективности исследователя, с 0,15 до 0,46, по словам авторов, в основном за счёт обучения во время тестирования (test-time training). На скрытых играх таблицы лидеров Kaggle заявка авторов набирает 0,20.
Ключевые факты
- MechEval размечает 69 повторяющихся механик в 20 играх ARC-AGI-3 и оценивает предсказания по клеткам, которые механика меняет.
- WARC, визуальный трансформер на 35 млн параметров, предобученный на других играх и обновляющий все параметры после каждого перехода.
- На отложенных играх WARC предсказывает четыре механики из пяти с точностью не ниже 80%; половина из них достигает её примерно за 80 воздействий, за одно прохождение игры.
- Без обновлений параметров во время теста такой точности достигает лишь одна механика из семи.
- WARC-Agent на публичных играх поднимает официальную оценку эффективности графового исследователя с 0,15 до 0,46; на скрытых играх Kaggle заявка авторов получила 0,20.
Почему это важно
Работа ставит измеримый вопрос о том, как быстро мировая модель осваивает правила незнакомой среды, и даёт для него метрику, число воздействий, нужных для точного предсказания механики. Результат говорит, что небольшая модель на 35 млн параметров, дообучающаяся прямо во время игры, справляется с большинством механик на отложенных играх, тогда как без обновлений параметров это удаётся лишь одной механике из семи.
Кому это важно
Исследователям мировых моделей, агентов для интерактивных сред и бенчмарка ARC-AGI-3, а также тем, кто занимается обучением во время тестирования: работа показывает, что вклад такого обучения в игровой результат заметен.
Как это применить
Прямого готового инструмента в описании нет. Практическая сторона, методическая: оценку MechEval можно использовать как образец того, как мерить скорость освоения механик, а связку мировой модели с фиксированным исследователем, как схему агента для игр с неизвестными правилами.
Можно ли доверять
Это препринт, и мы знаем о нём только по аннотации; в ней не названы авторы и организации. Цифры приводятся самими авторами. В аннотации не сказано, как результат 0,20 на скрытых играх Kaggle соотносится с другими заявками, и не уточнено, одинаковы ли метрика и агент для оценок 0,46 и 0,20. Прирост с 0,15 до 0,46 получен на публичных играх, и перенос его на скрытые игры в аннотации не заявлен.
Риски и подводные камни
Выводы касаются одного набора игр и 69 размеченных механик, так что обобщать их на другие среды рано. Основной прирост в игре, по словам авторов, даёт обучение во время тестирования, а значит, он зависит от возможности обновлять параметры по ходу работы. Заметно более низкий результат на скрытых играх Kaggle (0,20) против 0,46 на публичных играх осторожнее не сравнивать напрямую, так как совпадение метрик и агентов в аннотации не подтверждено.