Метод WISD улучшает рассуждающие модели с помощью их ослабленной копии
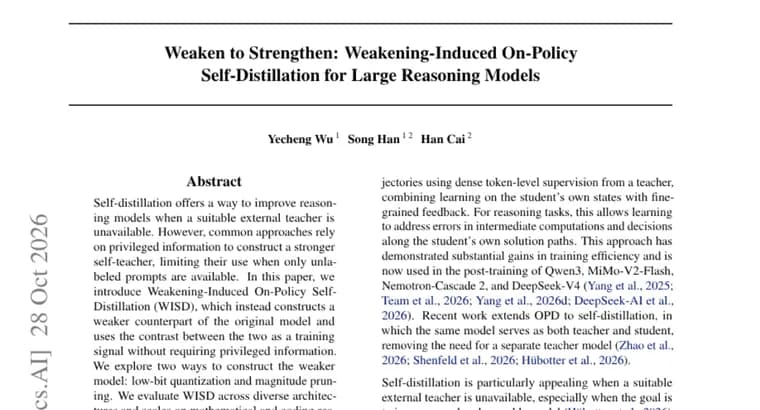
Статья описывает метод самодистилляции для больших рассуждающих моделей под названием Weakening-Induced On-Policy Self-Distillation (WISD). Самодистилляция нужна, когда подходящего внешнего учителя нет. По словам авторов, распространённые подходы опираются на привилегированную информацию (privileged information), чтобы построить более сильного «учителя» из самой модели. Из-за этого их трудно применять, когда есть только неразмеченные запросы.
WISD идёт в обратную сторону: вместо усиления учителя строится ослабленный аналог исходной модели, а контраст между ними используется как обучающий сигнал. Привилегированная информация не требуется. Авторы проверили два способа ослабления: низкобитное квантование и обрезку весов по величине (magnitude pruning).
Метод оценивали на разных архитектурах и масштабах моделей, на задачах математического и программистского рассуждения. По усреднённым результатам квантование и обрезка весов повышают точность относительно исходных моделей на 4,0 и 5,5 процентного пункта соответственно. Авторы называют это результатом уровня state-of-the-art (лучшим на данный момент), причём без привилегированной информации.
Отдельные примеры из аннотации. Обрезка весов поднимает точность Qwen3.5-4B на HMMT 2025 с 57,7% до 70,5%, а на LiveCodeBench v6, с 39,1% до 56,7%. Квантование поднимает точность Qwen3.6-35B-A3B с 68,5% до 74,6% на HMMT 2025 и с 61,8% до 69,5% на LiveCodeBench v6. Авторы заключают, что результаты утверждают WISD как новый и эффективный каркас самодистилляции для больших рассуждающих моделей.
Ключевые факты
- WISD (Weakening-Induced On-Policy Self-Distillation) строит ослабленную копию модели и использует разницу между исходной и ослабленной версиями как обучающий сигнал.
- Привилегированная информация не нужна, поэтому метод применим, когда есть только неразмеченные запросы.
- Ослабление делают двумя способами: низкобитным квантованием и обрезкой весов по величине.
- Средняя точность на математических и программистских задачах растёт на 4,0 п.п. (квантование) и 5,5 п.п. (обрезка) относительно исходных моделей.
- Qwen3.5-4B с обрезкой весов: HMMT 2025 с 57,7% до 70,5%, LiveCodeBench v6 с 39,1% до 56,7%; Qwen3.6-35B-A3B с квантованием: 68,5% → 74,6% и 61,8% → 69,5% на тех же тестах.
Почему это важно
Обычно рассуждающую модель улучшают с помощью более сильного учителя или привилегированной информации. WISD предлагает другой путь: сделать из самой модели более слабую версию и учиться на различии. Если заявленные авторами приросты подтвердятся, это способ улучшать модель, имея только неразмеченные запросы. Особенно заметны цифры для небольшой Qwen3.5-4B: рост на HMMT 2025 с 57,7% до 70,5% и на LiveCodeBench v6 с 39,1% до 56,7%.
Кому это важно
Исследователям и командам, которые дообучают рассуждающие модели и не располагают внешним учителем или размеченными данными с привилегированной информацией. Также тем, кто следит за методами самодистилляции для математических и программистских задач.
Как это применить
Практическая схема по описанию такая: взять исходную рассуждающую модель, получить её ослабленную копию (низкобитным квантованием или обрезкой весов по величине), затем использовать контраст между исходной и ослабленной версиями как сигнал для дообучения на неразмеченных запросах. Конкретная разрядность квантования, доля обрезаемых весов, затраты на обучение и ссылки на код или модели в тексте не указаны, поэтому для воспроизведения понадобится полный текст статьи.
Можно ли доверять
Это краткое описание статьи (аннотация) на странице Hugging Face Papers; результаты принадлежат самим авторам, независимая проверка не упоминается. Авторы и организации в тексте не названы. Не указано, какие именно тесты входят в усреднённый прирост 4,0 и 5,5 п.п., сколько было моделей и тестов, и с какими базовыми методами сравнивали утверждение о state-of-the-art. Пока это предварительная заявка, а не подтверждённый результат.
Риски и подводные камни
В тексте не объяснено, почему контраст с ослабленной моделью даёт полезный обучающий сигнал, поэтому границы применимости метода неясны. Результаты приведены только для математических и программистских задач; за их пределы перенос не показан. Нет данных о стоимости обучения, а также о разрядности квантования и степени обрезки, от которых, вероятно, зависит результат. Громкое «state-of-the-art» не подкреплено названием конкурирующих методов.