Метод TTME обновляет память вместо весов и обошёл TTT на пяти задачах
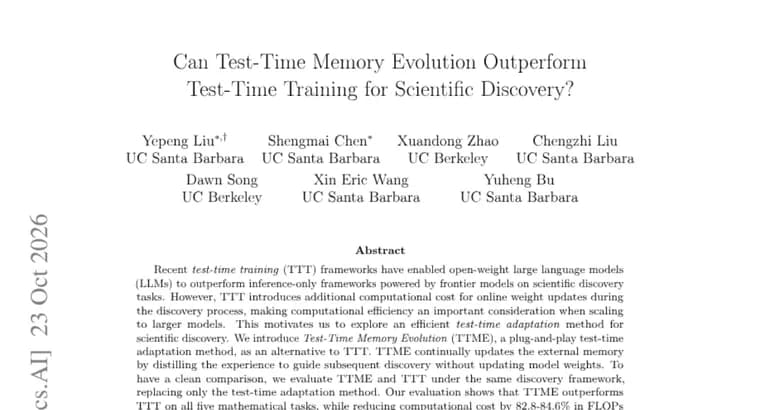
В препринте предложен метод Test-Time Memory Evolution (TTME), «эволюция памяти на этапе вывода». Он задуман как альтернатива обучению на этапе вывода (test-time training, TTT) в задачах научного открытия.
Контекст, который дают авторы: недавние TTT-фреймворки позволили моделям с открытыми весами обходить на задачах научного открытия фреймворки, где работает только вывод (inference-only) на передовых моделях. Но у TTT есть цена: во время поиска приходится обновлять веса модели онлайн, а это дополнительные вычисления. При переходе к более крупным моделям вычислительная эффективность становится важным фактором. Отсюда мотивация искать более дешёвый способ адаптации на этапе вывода.
TTME, подключаемый (plug-and-play) метод адаптации на этапе вывода. Он непрерывно обновляет внешнюю память: извлекает опыт из предыдущих попыток и сжимает его так, чтобы он направлял последующий поиск. Веса модели при этом не обновляются.
Для чистоты сравнения TTME и TTT оценивали в одном и том же фреймворке научного открытия, заменяя только метод адаптации на этапе вывода. Результат по заявлению авторов: TTME превосходит TTT на всех пяти математических задачах, при этом вычислительные затраты в FLOPs ниже на 82,8-84,6%, а время работы короче на 47,7-58,4% (это диапазоны по оценённым задачам). Авторы делают вывод, что TTME, эффективная и вычислительно экономная альтернатива TTT, но оговаривают, что это относится к оценённым сценариям научного открытия.
Ключевые факты
- TTME (Test-Time Memory Evolution) адаптирует систему на этапе вывода, обновляя внешнюю память опытом и не трогая веса модели.
- Сравнение с TTT проводилось в одном и том же фреймворке научного открытия: менялся только метод адаптации.
- По результатам авторов, TTME превосходит TTT на всех пяти математических задачах.
- Вычислительные затраты ниже на 82,8-84,6% по FLOPs, время работы короче на 47,7-58,4% (диапазоны по задачам).
- Вывод авторов ограничен оценёнными сценариями научного открытия.
Почему это важно
Обучение на этапе вывода (TTT) помогло моделям с открытыми весами обходить в научном поиске фреймворки на передовых моделях, но требует онлайн-обновления весов и лишних вычислений. TTME предлагает другой путь: накапливать опыт во внешней памяти. По заявлению авторов, это даёт лучший результат на пяти математических задачах при сокращении FLOPs на 82,8-84,6% и времени работы на 47,7-58,4%.
Кому это важно
Исследователям, которые строят системы автоматизированного научного открытия на базе больших языковых моделей, и тем, кто задумывается о цене адаптации на этапе вывода при переходе к более крупным моделям. Также тем, кто сравнивает подходы «менять веса» и «менять память».
Как это применить
TTME описан как подключаемый метод адаптации: в экспериментах им заменяли TTT, не меняя остальной фреймворк научного открытия. Практический смысл, в похожих конвейерах можно проверить замену обновления весов на обновление внешней памяти, сравнивая качество и затраты. Конкретные детали реализации в имеющемся описании не приведены.
Можно ли доверять
Это препринт, и все цифры, заявления самих авторов. Из описания видны только диапазоны экономии и сам факт превосходства на пяти задачах: сами задачи не названы, абсолютные показатели качества TTME и TTT не приведены. Сравнение выглядит аккуратным, потому что меняется только метод адаптации, но независимой проверки в описании нет.
Риски и подводные камни
Вывод авторов ограничен оценёнными сценариями: речь о пяти математических задачах, и переносимость на другие области науки не заявлена. Диапазоны экономии не привязаны к конкретным задачам. Не указано, на каких моделях и какого размера получены результаты, поэтому судить об эффекте для более крупных моделей пока нельзя.