Метод DTCA улучшил математику у диффузионной модели LLaDA-8B-Instruct: до +9,0 пункта на MATH500
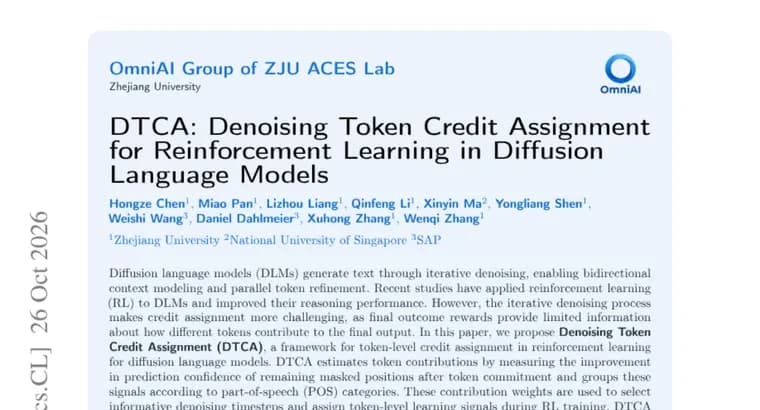
Диффузионные языковые модели генерируют текст не слева направо, а через итеративное удаление шума: это позволяет учитывать контекст в обе стороны и уточнять сразу много токенов параллельно. Недавние работы уже применяли к таким моделям обучение с подкреплением (RL) и улучшали их способность к рассуждению.
Проблема, на которую указывают авторы статьи: из-за итеративного удаления шума сложнее назначать «заслугу» (credit assignment). Итоговая награда за готовый ответ даёт лишь ограниченную информацию о том, какой вклад в результат внесли отдельные токены.
Для решения предложен метод Denoising Token Credit Assignment (DTCA), каркас для назначения заслуги на уровне токенов при RL-обучении диффузионных языковых моделей. Он работает так: вклад токена оценивается по тому, насколько вырастает уверенность предсказания для оставшихся замаскированных позиций после того, как этот токен зафиксирован. Эти сигналы группируются по частям речи (POS). Полученные веса вклада используются двояко: чтобы выбирать информативные шаги удаления шума и чтобы назначать токенам обучающие сигналы во время RL. Дополнительно сигналы калибруются по изменениям энтропии на уровне токенов, вызванным обновлениями политики.
Результат: в экспериментах на LLaDA-8B-Instruct DTCA стабильно улучшает решение математических задач при разных бюджетах генерации. Прирост относительно базовой модели достигает 9,0 пункта на MATH500 и 5,3 пункта на GSM8K.
Ключевые факты
- DTCA (Denoising Token Credit Assignment), метод назначения заслуги на уровне токенов при обучении с подкреплением диффузионных языковых моделей.
- Вклад токена оценивается по росту уверенности предсказания оставшихся замаскированных позиций после фиксации токена; сигналы группируются по частям речи.
- Веса вклада помогают выбирать информативные шаги удаления шума и задавать токенам обучающие сигналы; дополнительно сигналы калибруются по изменениям энтропии, вызванным обновлением политики.
- На LLaDA-8B-Instruct метод стабильно улучшает математические результаты при разных бюджетах генерации: до 9,0 пункта на MATH500 и 5,3 пункта на GSM8K к базовой модели.
Почему это важно
Диффузионные языковые модели, альтернатива привычной пошаговой генерации, и обучение с подкреплением для них только осваивается. Главная трудность, понять, какие токены на самом деле привели к верному ответу, ведь награда выдаётся лишь за итог. DTCA предлагает конкретный способ получить более тонкий сигнал на уровне токенов и показывает рост на двух математических тестах.
Кому это важно
Прежде всего исследователям, которые обучают диффузионные языковые модели с помощью RL и ищут способы улучшить рассуждение. Остальным читателям это скорее сигнал о направлении работ, чем готовый продукт.
Как это применить
В описании нет сведений о выложенном коде, затратах на обучение и деталях реализации, так что практически применить метод по этому тексту нельзя. Идею можно использовать как ориентир: оценивать вклад токена по тому, как он повышает уверенность в оставшихся замаскированных позициях, и калибровать сигналы по изменению энтропии.
Можно ли доверять
Все цифры, заявления самих авторов из аннотации. Прирост указан относительно базовой модели LLaDA-8B-Instruct; абсолютные оценки базовой модели и DTCA в тексте не приведены. Для MATH500 названо «до 9,0 пункта», то есть верхняя граница; для GSM8K, 5,3 пункта, и максимум это или типичное значение, не сказано. Сравнения с другими методами назначения заслуги в аннотации нет.
Риски и подводные камни
Результат получен на одной модели (LLaDA-8B-Instruct) и двух математических тестах, поэтому перенос на другие модели, размеры и задачи не подтверждён. Бюджеты генерации в аннотации не уточнены, а формулировка «до 9,0 пункта» отражает лучший случай, а не средний прирост.