Метод Speculative Listening в среднем на 73% снижает задержку ответа речевых нейросетей
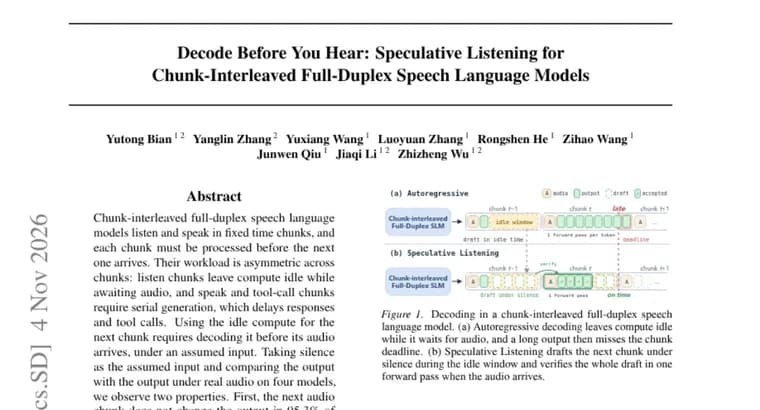
Полнодуплексные речевые языковые модели с чередованием отрезков (chunk-interleaved) слушают и говорят фиксированными по времени отрезками, и каждый отрезок нужно обработать до прихода следующего. Нагрузка при этом неравномерна: на отрезках «слушания» вычислительные ресурсы простаивают в ожидании звука, а отрезки «речи» и «вызова инструмента» требуют последовательной генерации, из-за чего ответы и вызовы инструментов задерживаются.
Чтобы использовать простой, следующий отрезок нужно декодировать до того, как придёт его звук, то есть при предполагаемом входе. Авторы взяли в качестве такого входа тишину и на четырёх моделях сравнили выход при тишине с выходом при реальном звуке. Они отмечают два свойства. Во-первых, следующий отрезок звука не меняет выход в 95,3% отрезков. Во-вторых, 88% изменений начинаются уже с первого выходного токена.
На этих наблюдениях построен метод Speculative Listening, не требующая обучения и не искажающая результат (lossless) схема самоспекулятивного декодирования на этапе ввода. Во время простоя модель набрасывает черновик следующего отрезка в предположении тишины, а для случаев, когда изменение начинается с первого токена, строит вторую ветку, от запасного (следующего по вероятности) первого токена. Все черновики хранятся в общем пуле гипотез, который переходит между отрезками, и проверяются, когда приходит реальный звук.
На собственном восьмизадачном бенчмарке TickTock-Bench авторы сообщают об ускорении отрезков речи в 2,6-2,8 раза и отрезков вызова инструментов, до 23,4 раза. В среднем метод сокращает задержку декодирования перед началом ответа на 73%, до 74-241 мс, что близко к паузе около 200 мс между репликами людей. Максимальное отставание от реального времени в среднем снижается на 94,4%.
Ключевые факты
- Наблюдение на четырёх моделях: при подстановке тишины вместо следующего звука выход не меняется в 95,3% отрезков, а 88% изменений начинаются с первого выходного токена.
- Speculative Listening, метод без дообучения и без потери качества: пока модель простаивает, она заранее декодирует следующий отрезок, а при приходе реального звука проверяет черновики.
- На бенчмарке TickTock-Bench (восемь задач) отрезки речи ускоряются в 2,6-2,8 раза, отрезки вызова инструментов, до 23,4 раза.
- В среднем задержка до начала ответа снижается на 73%, до 74-241 мс, а максимальное отставание от реального времени, на 94,4%.
- Результаты получены на бенчмарке самих авторов; сравнения с другими методами спекулятивного декодирования в аннотации нет.
Почему это важно
Для голосовых нейросетей, которые слушают и отвечают одновременно, решающее значение имеет скорость реакции: человеческая пауза между репликами около 200 мс. Работа указывает на неиспользуемый ресурс, простой на отрезках слушания, и показывает, как превратить его в выигрыш по задержке. Заявленная средняя задержка 74-241 мс приближается к этому ориентиру, хотя речь идёт о результатах на собственном бенчмарке авторов.
Кому это важно
Исследователям и разработчикам полнодуплексных речевых моделей и голосовых ассистентов, особенно тем, кто добавляет вызовы инструментов в голосовой диалог: именно на отрезках вызова инструментов заявлено наибольшее ускорение (до 23,4 раза).
Как это применить
Метод заявлен как не требующий обучения, то есть теоретически его можно подключить к уже готовой модели с чередованием отрезков. Суть реализации: на простое строить черновик следующего отрезка при тишине, добавлять вторую ветку от запасного первого токена, хранить черновики в пуле гипотез и проверять их при поступлении реального звука. Опубликован ли код, в аннотации не сказано в явном виде, поэтому внедрение потребует собственной реализации по описанию.
Можно ли доверять
Это препринт, представленный на Hugging Face Papers; рецензирования в тексте не упомянуто. Показатели ускорения получены на восьмизадачном бенчмарке TickTock-Bench, названном самими авторами «нашим». Названия четырёх моделей, длина отрезка в миллисекундах и то, на какой модели или задаче достигнут максимум 23,4x, в тексте не указаны. Сравнения с другими методами спекулятивного декодирования в аннотации нет.
Риски и подводные камни
Метод опирается на то, что следующий звук обычно не меняет выход (95,3% отрезков при тишине); в оставшихся случаях черновик придётся отбросить. Цифра 23,4x, это максимум («до»), а не типичное значение: для речевых отрезков заявлено 2,6-2,8x. Средние снижения задержки (73%) и отставания (94,4%) относятся к бенчмарку авторов и могут не воспроизвестись на других моделях и данных.