Метод SMD сжимает диффузионные модели до 4 шагов без состязательного обучения
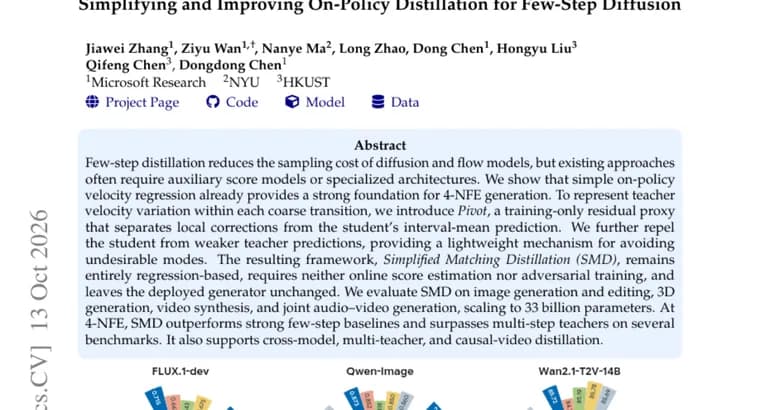
Дистилляция в несколько шагов снижает стоимость сэмплирования у диффузионных моделей и flow-моделей, но, как пишут авторы препринта, существующие подходы часто требуют вспомогательных score-моделей или специальных архитектур. Работа предлагает более простой путь.
Исходная идея: простая регрессия скорости (velocity regression) по траекториям самой ученической модели, то есть on-policy, уже даёт прочную основу для генерации за 4 NFE (4 вычисления сети, то есть 4 шага сэмплирования). Поверх этого вводятся две добавки. Первая, Pivot, вспомогательный остаточный прокси, который используется только при обучении: он отделяет локальные поправки от предсказания ученика, усреднённого по интервалу, и нужен, чтобы передать изменение скорости учителя внутри каждого крупного перехода. Вторая, отталкивание ученика от более слабых предсказаний учителя; авторы называют это лёгким механизмом, помогающим избегать нежелательных мод.
Итоговый фреймворк называется Simplified Matching Distillation (SMD). По заявлению авторов, он целиком построен на регрессии, не требует ни онлайн-оценки score, ни состязательного обучения и не меняет итоговый генератор, который идёт в работу.
SMD проверяли на генерации и редактировании изображений, 3D-генерации, синтезе видео и совместной генерации аудио и видео; максимальный масштаб, 33 миллиарда параметров. По заявлению авторов, при 4 NFE метод превосходит сильные базовые методы с малым числом шагов и на ряде бенчмарков обходит многошаговых учителей. Кроме того, SMD поддерживает дистилляцию между разными моделями, из нескольких учителей и дистилляцию каузального видео.
Ключевые факты
- SMD (Simplified Matching Distillation), дистилляция диффузионных и flow-моделей в генерацию за 4 NFE (4 шага).
- Основа, простая on-policy регрессия скорости; дополнительно вводится Pivot, остаточный прокси, используемый только при обучении, и отталкивание ученика от слабых предсказаний учителя.
- По словам авторов, метод целиком регрессионный: без онлайн-оценки score и без состязательного обучения, итоговый генератор не меняется.
- Проверка охватывает изображения (генерация и редактирование), 3D, видео и совместную генерацию аудио и видео, масштаб до 33 млрд параметров.
- При 4 NFE SMD, по заявлению авторов, превосходит сильные базовые методы и на нескольких бенчмарках обходит многошаговых учителей.
Почему это важно
Диффузионные модели дороги в использовании из-за многих шагов сэмплирования, поэтому дистилляция в 4 шага, одно из главных направлений удешевления. Заявка работы в том, что для этого не нужны ни дополнительные score-модели, ни состязательное обучение, ни особая архитектура: достаточно регрессии с двумя небольшими добавками. Если это подтвердится независимо, рецепт упрощает пайплайн дистилляции.
Кому это важно
Исследователям и инженерам, которые ускоряют диффузионные и flow-модели для изображений, видео, 3D и совместной генерации звука и видео. Отдельно заметно, что авторы заявляют работу с моделями до 33 млрд параметров и поддержку дистилляции между разными моделями, из нескольких учителей и дистилляции каузального видео.
Как это применить
Практическая сторона по тексту следующая: Pivot используется только при обучении, а развёрнутый генератор остаётся прежним, то есть на этапе использования ничего дополнительно менять не придётся. О выпуске кода или моделей в источнике ничего не сказано, так что воспроизводить метод пока предстоит по описанию из статьи.
Можно ли доверять
Это препринт, представленный на Hugging Face Papers, и все утверждения принадлежат самим авторам. В тексте нет названий бенчмарков, значений метрик и величины улучшений: формулировка «на нескольких бенчмарках» не раскрыта. Не названы также учителя, базовые методы и наборы данных, поэтому оценить силу результата без полного текста статьи нельзя.
Риски и подводные камни
Не указано, какая именно модель на 33 млрд параметров использовалась и в какой модальности, не приведены затраты на обучение и выигрыш по времени. Описаний ограничений и неудачных случаев в тексте нет, а превосходство над многошаговыми учителями заявлено лишь на части бенчмарков, не на всех. Перед использованием результаты стоит перепроверять.