Метод PMD ускоряет диффузионные модели: лучший FID среди 4-шаговых на SDXL и FLUX.2
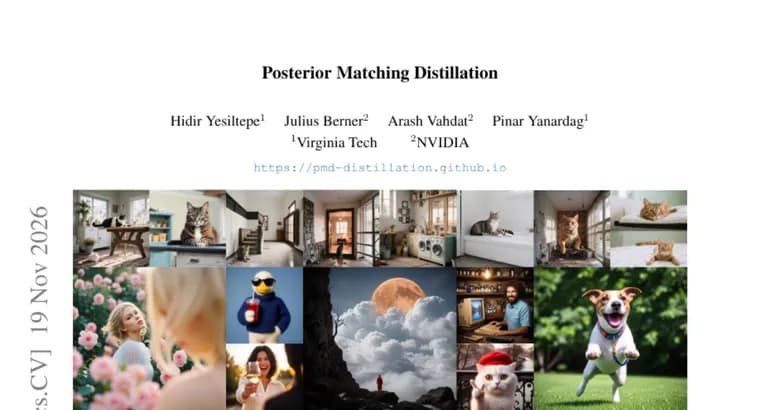
В препринте представлен метод Posterior Matching Distillation (PMD) для дистилляции диффузионных моделей. Дистилляция сжимает многошаговый процесс генерации предобученной модели-учителя до нескольких вычислений сети, что ускоряет создание изображений и видео. Один из подходов, распределительные методы: они подгоняют распределение выходов модели-ученика под распределение учителя.
Проблема, на которую указывают авторы: такая подгонка часто строится на обратной KL-дивергенции (reverse-KL), у которой есть смещение в сторону доминирующих мод учителя. В результате страдает разнообразие образцов. PMD, новый представитель семейства распределительных методов, который сочетает покрытие мод (mode-covering) при выборке из апостериорного распределения с генерацией при любом числе шагов (any-step).
По словам авторов, при нулевой популяционной потере PMD восстанавливает полное апостериорное распределение чистых изображений учителя на каждом обученном уровне шума. Стохастический ученик поддерживает любые бюджеты шагов выборки в пределах обученной сетки временных шагов без дополнительного обучения.
Механика такая: PMD сопоставляет экспоненциально перевзвешенные средние по образцам ученика при фиксированном зашумлённом состоянии с соответствующими апостериорными средними учителя. При гауссовом зашумлении экспоненциально «наклонённое» (tilted) апостериорное среднее сводится к одному вычислению учителя на сдвинутом входе. Авторы доказывают, что совпадение наклонённых средних на открытой окрестности однозначно определяет полное апостериорное распределение. Так PMD контролирует всё условное распределение через семейство ограничений на средние, без вспомогательной сети, оценивающей score ученика.
Эксперименты проведены на SDXL и FLUX.2 [klein] 4B. По заявлению авторов, PMD показывает лучший FID среди 4-шаговых методов на обеих моделях и при этом сохраняет конкурентные или лидирующие результаты по метрикам соответствия промпту и перцептивного качества.
Ключевые факты
- PMD, новый метод распределительной дистилляции диффузионных моделей: он сочетает выборку из апостериорного распределения с покрытием мод и генерацией при любом числе шагов.
- Мотивация: обратная KL-дивергенция, на которой часто строят подгонку распределений, смещена к доминирующим модам учителя и снижает разнообразие образцов.
- Вспомогательная сеть, оценивающая score ученика, не нужна: всё условное распределение контролируется через семейство ограничений на средние.
- Авторы доказывают, что совпадение наклонённых средних на открытой окрестности однозначно задаёт полное апостериорное распределение.
- На SDXL и FLUX.2 [klein] 4B заявлен лучший FID среди 4-шаговых методов при конкурентных или лидирующих метриках соответствия промпту и перцептивного качества.
Почему это важно
Дистилляция ускоряет генерацию диффузионных моделей: многошаговый процесс сжимается до нескольких вычислений сети. Типичная беда, потеря разнообразия, потому что ученик «схлопывается» к самым частым модам учителя. PMD атакует именно это место: метод нацелен на восстановление полного апостериорного распределения, а не только его доминирующих пиков. Дополнительно заявлена гибкость: один обученный ученик работает с разным числом шагов в пределах обученной сетки временных шагов.
Кому это важно
Исследователям диффузионных моделей и дистилляции, а также командам, которые ускоряют генерацию изображений на базе SDXL или FLUX.2 [klein] 4B и для которых важно разнообразие результатов. Для обычных пользователей генераторов изображений это пока научный результат, а не готовый продукт.
Как это применить
Из текста аннотации видно только описание метода и результат на двух моделях: SDXL и FLUX.2 [klein] 4B. Практическое применение потребует чтения полной статьи: аннотация не описывает ни конкретных настроек, ни порядка воспроизведения. Идея, на которую стоит обратить внимание разработчикам: обучение без вспомогательной сети, оценивающей score ученика, упрощает схему дистилляции.
Можно ли доверять
Это препринт, а все утверждения о результатах, заявления самих авторов из аннотации. В источнике нет числовых значений FID, названий методов, с которыми идёт сравнение, и перечня метрик соответствия промпту и перцептивного качества, поэтому величину преимущества по тексту оценить нельзя. Теоретическое утверждение о восстановлении полного апостериорного распределения сформулировано при условии нулевой популяционной потери, это идеализированный случай. Независимой проверки в источнике нет.
Риски и подводные камни
Лучший FID заявлен только среди 4-шаговых методов; результатов для других числовых бюджетов шагов в источнике нет, как и количественных оценок режима any-step. Сама по себе метрика FID не гарантирует, что разнообразие образцов действительно сохранено лучше, чем у конкурентов. Сведений о выпуске кода, весов и о вычислительных затратах обучения в источнике нет, так что воспроизводимость и цена внедрения пока неясны.