Максимальный уровень рассуждения у ИИ-агентов обходится до 42 раз дороже минимального на лёгких задачах
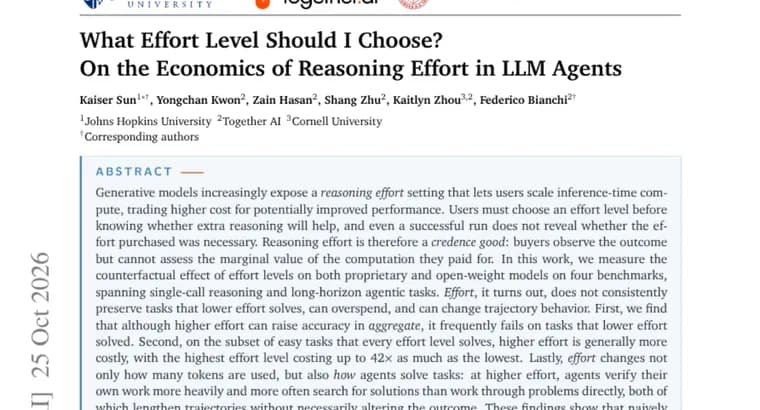
Современные генеративные модели всё чаще дают пользователю настройку «уровень рассуждения» (reasoning effort): она позволяет наращивать вычисления на этапе ответа, платя больше ради потенциально лучшего результата. Проблема в том, что выбирать уровень приходится заранее, не зная, поможет ли дополнительное рассуждение. Даже после удачного запуска неясно, нужен ли был потраченный объём вычислений. Авторы работы называют это «благом доверия» (credence good): покупатель видит итог, но не может оценить предельную ценность вычислений, за которые заплатил.
Чтобы проверить, что на самом деле даёт повышение уровня, авторы измерили контрфактический эффект разных уровней рассуждения на проприетарных и на открытых (open-weight) моделях. Использовано четыре бенчмарка: от задач на рассуждение за один вызов до долгих агентных задач. Общий вывод: повышенный уровень не гарантирует сохранения задач, которые решались на более низком, может приводить к перерасходу и меняет траекторию поведения агента.
Три конкретных наблюдения. Первое: высокий уровень может поднимать точность в целом, но часто проваливает задачи, которые решал низкий уровень. Второе: на подмножестве лёгких задач, которые решаются на любом уровне, более высокий уровень в целом обходится дороже, причём самый высокий, до 42 раз дороже самого низкого. Третье: уровень меняет не только число израсходованных токенов, но и сам способ решения. При высоком уровне агенты сильнее проверяют собственную работу и чаще ищут решение, а не прорабатывают задачу напрямую; и то и другое удлиняет траекторию, не обязательно меняя результат.
Из этого авторы делают вывод: бездумно выбирать максимальный уровень не только невыгодно по стоимости, но и не гарантирует лучшего результата на конкретной задаче. Простая альтернатива, начинать с самого низкого уровня и повышать его только после подтверждённой неудачи. По их данным, такая стратегия не уступает фиксированному максимальному уровню или превосходит его на всех моделях и бенчмарках, а для большинства проприетарных моделей ещё и обходится дешевле.
Ключевые факты
- Высокий уровень рассуждения может повышать точность в целом, но часто проваливает задачи, которые решал низкий уровень.
- На лёгких задачах, решаемых на любом уровне, самый высокий уровень стоит до 42 раз дороже самого низкого.
- При высоком уровне агенты больше проверяют собственную работу и чаще ищут решение, а не прорабатывают задачу напрямую; траектория удлиняется, а результат не обязательно меняется.
- Предложенная стратегия: начинать с минимального уровня и повышать его только после подтверждённой неудачи.
- Такая стратегия не хуже фиксированного максимального уровня на всех моделях и четырёх бенчмарках, а для большинства проприетарных моделей дешевле.
Почему это важно
Настройка уровня рассуждения становится стандартной для нейросетей и ИИ-агентов, и многие по умолчанию выбирают максимум «на всякий случай». Работа показывает, что это не безобидная страховка: максимальный уровень на лёгких задачах стоит до 42 раз дороже минимального, а выигрыш в точности по отдельным задачам не гарантирован, потому что часть задач, решённых на низком уровне, на высоком проваливается. Кроме того, уровень влияет на стиль работы агента, а не только на число токенов.
Кому это важно
Командам, которые встраивают нейросети и ИИ-агентов в продукты и платят за вызовы через API, а также разработчикам агентных систем с длинными траекториями, где лишние проверки и поиск решения удлиняют работу. Полезно и тем, кто сравнивает проприетарные и открытые модели по соотношению цены и качества.
Как это применить
Практический совет из работы: не ставить максимальный уровень по умолчанию, а начинать с самого низкого и повышать уровень только после подтверждённой неудачи, то есть когда есть способ проверить, что результат неверен. Для этого нужна автоматическая проверка ответа. По данным авторов, такой подход на всех моделях и бенчмарках не уступает фиксированному максимуму, а для большинства проприетарных моделей дешевле.
Можно ли доверять
Пересказ сделан по аннотации работы на странице Hugging Face Papers. Названия моделей и бенчмарков, точные цифры точности и размер экономии там не приведены, поэтому проверить выводы по этому тексту нельзя. Цифра «до 42 раз» относится к лёгким задачам, решаемым на всех уровнях, и является верхней оценкой, а не средним или общим соотношением стоимости. Экономия указана только для большинства проприетарных моделей.
Риски и подводные камни
Стратегия «от минимума к максимуму» требует надёжного способа определить, что попытка провалилась; без него повышать уровень не по чему. Эскалация означает повторный запуск, поэтому на трудных задачах итоговая цена и задержка зависят от числа неудачных попыток. Результаты получены на четырёх бенчмарках и конкретных моделях; перенос на другие задачи и модели нужно проверять отдельно. Экономия заявлена не для всех моделей.
«Уровень рассуждения, это «благо доверия»: покупатель видит результат, но не может оценить предельную ценность вычислений, за которые заплатил.»
— Авторы работы, аннотация