Liquid AI представила LFM3: нейросети на ~2 млрд параметров для устройств
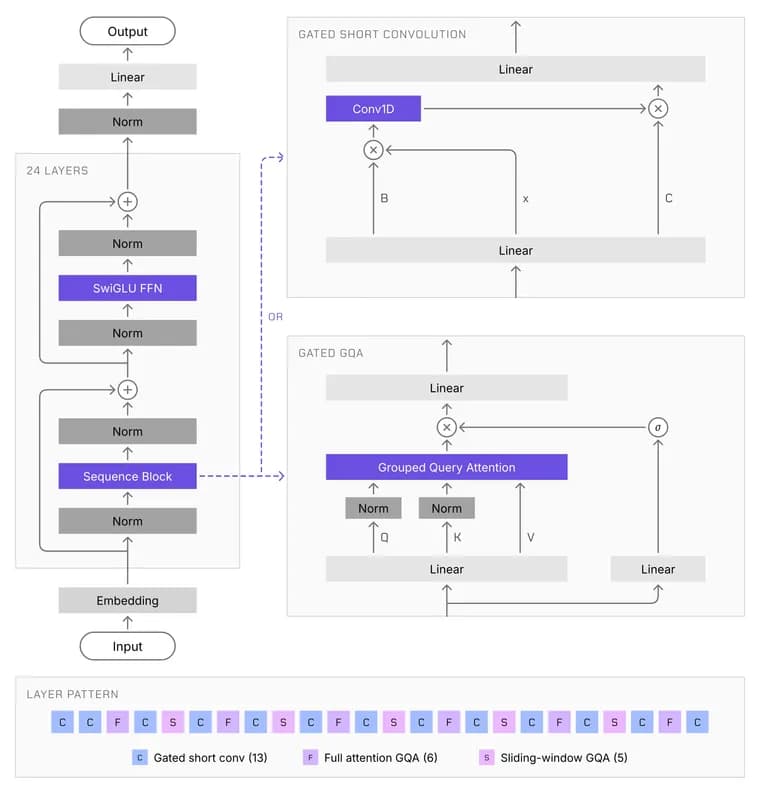
Liquid AI опубликовала в блоге на Hugging Face описание LFM3, нового поколения своих Liquid Foundation Models (LFM). Идея семейства: дать «отправную точку для специализированного интеллекта». Текстовая, визуальная, аудио-, omni-модель (принимает текст, изображение и звук, отвечает текстом и речью) и модель для принятия решений (decision) построены на одной общей основе, все в классе около 2 млрд параметров. Компания предлагает выбрать модель под свою модальность, дообучить её на своих данных на одной видеокарте и запускать там, где работает приложение. В тексте упомянуто «шесть моделей класса 2B», но перечислено пять типов; описания decision-модели в доступной части статьи нет.
Главное заявленное изменение по сравнению с LFM2, новая трёхкомпонентная гибридная архитектура и рецепт обучения. По словам Liquid AI, LFM3-1.7B превосходит LFM2.5-2.6B, имея на 35% меньше параметров. Основа LFM3-1.7B-Base состоит из 24 слоёв: 13 gated short convolutions (короткие свёртки с затвором, размер ядра 7 вместо 3 в LFM2), 5 слоёв внимания со скользящим окном в 256 токенов и 6 слоёв глобального внимания. Добавлены также затворное внимание по головам (сигмоидный затвор масштабирует выход каждой головы; по словам авторов, это может помочь подавлять выбросы активаций, мешающие квантованию), частичный RoPE в слоях глобального внимания (вращается только высокочастотная половина каждой головы) и «сэндвич»-нормализация (нормализуются и вход, и выход каждого блока). Архитектуру подбирал поиск «с железом в контуре» (hardware-in-the-loop): теперь он охватывает 14 сочетаний устройств и бэкендов, от телефонов и Raspberry Pi 5 до ноутбуков, облачных CPU, GPU и NPU Qualcomm Hexagon.
Выигрыш проявляется на длинном контексте: в пересчёте на параметр LFM3-1.7B на коротких запросах сопоставима по скорости с LFM2-1.2B на разных периферийных устройствах, а при 8K токенов в контексте быстрее примерно на 25%. Предобучение заняло 22 трлн токенов при словаре 128K (как у LFM2.5-8B-A1B); последние 3,5 трлн токенов, этап дообучения на отобранных данных с большей долей агентных трасс и вызовов инструментов, на нём же контекст расширен до 256K токенов. Текстовая модель в 4-битной точности помещается примерно в 1 ГБ.
Для зрения и звука созданы два собственных кодировщика. Визуальный сочетает свёртки и внимание, требует втрое меньше вычислений, чем SigLIP2 в прежних VL-моделях LFM; версия на 164 млн параметров, как утверждается, не уступает по точности визуальному кодировщику Qwen3.5-2B при в 2,2 раза меньшем числе FLOPs (замер с одной и той же языковой основой LFM2.5-230M). Для видео пара кадров кодируется в один временной срез, и длина временной последовательности сокращается вдвое. Аудиокодировщик полностью каузальный, поэтому модель может обрабатывать запрос, пока пользователь ещё говорит; время до первого токена, от 50 мс. Новый аудиотокенизатор LiquidCodec превращает токены в речь примерно в 87 раз быстрее реального времени на одном потоке CPU Apple M4 Max и поддерживает потоковое декодирование.
По моделям. LFM3-1.7B предназначена для локальных агентов, вызова инструментов, структурированного вывода и дообучения; её дообучали работать в агентных оболочках вроде Hermes Agent, Pi и OpenClaw. Самый заметный прирост, на агентных задачах: на WebArena-Verified она набирает 38,42 против 3,02 у LFM2.5-2.6B и, как заявлено, обходит Qwen3.5-9B на длинных задачах в браузерах и бизнес-приложениях. LFM3-VL-2B, первая визуальная модель LFM с видеовходом; она рассуждает по шагам и находит объекты и их расположение, что Liquid AI называет основой для робототехники. При 1,9 млрд параметров против 3,1 млрд у LFM2.5-VL-3B она поднимает среднее по 62 визуальным тестам с 57,6 до 71,4, на уровне Gemma 4 12B, которая более чем в шесть раз крупнее. LFM3-Audio-2B принимает текст или звук и отвечает текстом, речью или обоими; поддерживает голосовой чат, распознавание и синтез речи и перевод на 18 языках, умеет превращать голосовые просьбы в вызовы инструментов. Качество речи по UTMOSv2, 3,83 против 3,22 у LFM2.5-Audio-1.5B. LFM3-Omni-2B, первая omni-модель компании: на входе текст, изображение и звук, на выходе текст и речь; она может заменить связку из отдельных моделей распознавания речи, визуально-языковой модели, LLM и синтеза речи. По заявлению авторов, на тестах Daily-Omni, WorldSense и AV-SpeakerBench по аудиовизуальному пониманию видео она обходит модели до 10,7 млрд параметров, например Qwen2.5-Omni-7B.
В статье для каждой модели приведены примеры запуска в библиотеке transformers (для VL-модели нужна версия не ниже 5.21.0, для аудио- и omni-модели, не ниже 5.20.2); идентификаторы моделей находятся в пространстве LiquidAI на Hugging Face. Видимая часть материала обрывается посреди примера кода для LFM3-Omni-2B.
Ключевые факты
- LFM3, новое поколение моделей Liquid AI: текст, зрение, аудио, omni и decision в классе около 2 млрд параметров на общей основе LFM3-1.7B-Base; каждую можно дообучить на одной видеокарте.
- Архитектура из 24 слоёв: 13 коротких свёрток, 5 слоёв внимания со скользящим окном в 256 токенов и 6 слоёв глобального внимания; контекст текстовой модели, 256K токенов, 4-битная версия занимает около 1 ГБ.
- По данным Liquid AI, LFM3-1.7B с 35% меньшим числом параметров превосходит LFM2.5-2.6B: на WebArena-Verified 38,42 против 3,02.
- LFM3-VL-2B (1,9 млрд параметров) поднимает среднее по 62 визуальным тестам с 57,6 до 71,4 и принимает видео; LFM3-Audio-2B поддерживает 18 языков, а LFM3-Omni-2B принимает текст, изображение и звук и отвечает текстом и речью.
- Новые собственные кодировщики: визуальный требует втрое меньше вычислений, чем SigLIP2; аудио, время до первого токена от 50 мс, LiquidCodec генерирует речь примерно в 87 раз быстрее реального времени на одном потоке Apple M4 Max.
Почему это важно
Liquid AI делает ставку на небольшие модели, которые работают прямо на устройстве, и в LFM3 собирает под одной основой все основные модальности. Заявленный выигрыш, больше возможностей на параметр: текстовая модель с 35% меньшим числом параметров обходит предшественницу, а визуальная при 1,9 млрд параметров, по словам компании, сравнима с Gemma 4 12B. Для задач, где нет места облаку (телефоны, встраиваемые устройства, робототехника), это шаг к тому, чтобы агентам, зрению и голосу хватало одной небольшой модели.
Кому это важно
Разработчикам локальных агентов и приложений с вызовом инструментов, командам, которым нужны компактные модели для зрения, голоса или видео на ноутбуке и периферийных устройствах, а также тем, кто хочет дообучить модель на собственных данных и терминологии на одной видеокарте. Заметно и тем, кто сейчас собирает связку из отдельных моделей распознавания речи, визуально-языковой модели, LLM и синтеза речи: LFM3-Omni-2B задумана как замена такой связке.
Как это применить
Каждая модель запускается в библиотеке transformers; в статье есть готовые примеры для LFM3-1.7B, LFM3-VL-2B, LFM3-Audio-2B и LFM3-Omni-2B (идентификаторы вида LiquidAI/LFM3-1.7B, в примерах используется trust_remote_code=True). Для VL-модели нужен transformers версии не ниже 5.21.0, для аудио и omni, не ниже 5.20.2. Список других поддерживаемых движков вывода, включая llama.cpp, и подробности, в карточках моделей; для локальных агентов есть отдельное руководство Agent Harnesses. Условия лицензии и цены в доступной части статьи не указаны, смотрите карточки моделей.
Можно ли доверять
Это первичный материал самой Liquid AI, опубликованный в блоге на Hugging Face. Все сравнения и результаты тестов, собственные данные компании; независимых проверок в тексте нет. В доступной части приведён лишь один результат LFM3-1.7B на агентных задачах (WebArena-Verified), остальные цифры по этой модели не раскрыты. Не сказано, как измерен объём около 1 ГБ и какая схема квантования использована. Видимая часть статьи обрывается на середине примера кода, поэтому описание decision-модели и выводы недоступны.
Риски и подводные камни
Заявления «лучше предшественницы», «на уровне Gemma 4 12B» и «обходит Qwen3.5-9B» относятся к конкретным наборам тестов, выбранным самой компанией; на ваших задачах результат может отличаться. В тексте упомянуты шесть моделей, но названы пять типов, и decision-модель не описана, состав семейства стоит проверять по картам моделей. В примерах используется trust_remote_code=True, то есть исполняется код из репозитория модели, а для разных модальностей нужны разные минимальные версии transformers. Для VL-модели в примере задан большой лимит новых токенов (16384), так как рассуждение может быть длинным.