Long-WAM: длинная история видео подняла успех робота до 78,7%
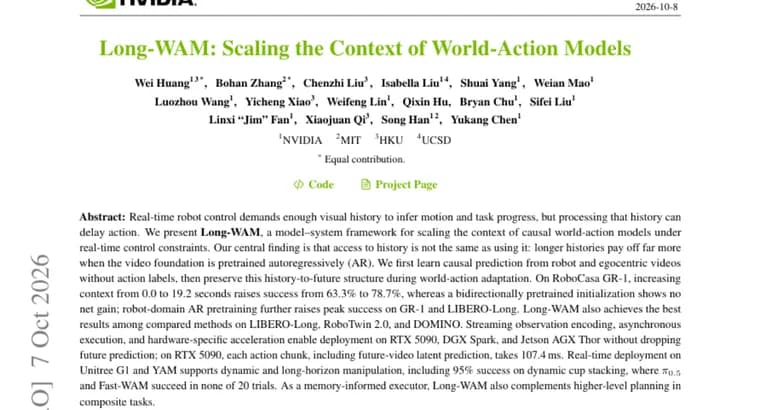
Для управления роботом в реальном времени нужно достаточно визуальной истории, чтобы понимать движение и ход выполнения задачи, но обработка этой истории задерживает действие. Статья предлагает Long-WAM, системный подход (модель плюс система исполнения) для наращивания контекста причинных моделей мира и действий (world-action models) при ограничениях реального времени.
Центральный вывод авторов: доступ к истории не равен её использованию. Длинная история окупается заметно сильнее, когда видеооснову предобучали авторегрессионно (AR). Обучение идёт в два этапа: сначала причинное предсказание изучают на видео с роботами и видео от первого лица без разметки действий, затем эту структуру «история → будущее» сохраняют при адаптации к задачам с действиями.
На RoboCasa GR-1 рост контекста с 0,0 до 19,2 секунды поднимает успех с 63,3% до 78,7% (абсолютные доли успеха). Инициализация с двунаправленным предобучением при этом не даёт чистого выигрыша. AR-предобучение на данных роботов дополнительно повышает пиковый успех на GR-1 и LIBERO-Long. По словам авторов, Long-WAM показывает лучшие результаты среди сравниваемых методов на LIBERO-Long, RoboTwin 2.0 и DOMINO.
Для реального времени используют потоковое кодирование наблюдений, асинхронное исполнение и аппаратно-специфичное ускорение. Это позволяет запускать систему на RTX 5090, DGX Spark и Jetson AGX Thor без отказа от предсказания будущего. На RTX 5090 один фрагмент действий (action chunk) вместе с предсказанием латентного представления будущего видео занимает 107,4 мс.
На реальных роботах Unitree G1 и YAM система справляется с динамичными и долгими манипуляциями: 95% успеха в динамичной укладке стаканов друг на друга, тогда как Pi0.5 и Fast-WAM не добились успеха ни в одной из 20 попыток. Как исполнитель с памятью, Long-WAM также дополняет планирование более высокого уровня в составных задачах.
Ключевые факты
- На RoboCasa GR-1 рост контекста с 0,0 до 19,2 с поднимает успех с 63,3% до 78,7%; у модели с двунаправленным предобучением чистого выигрыша нет.
- Главный вывод авторов: длинная история окупается заметно сильнее, если видеооснову предобучали авторегрессионно, а сначала причинное предсказание учат на видео без разметки действий.
- На RTX 5090 один фрагмент действий вместе с предсказанием будущего видео занимает 107,4 мс; также заявлен запуск на DGX Spark и Jetson AGX Thor.
- На Unitree G1 и YAM, 95% успеха в динамичной укладке стаканов, у Pi0.5 и Fast-WAM, ни одного успеха в 20 попытках.
- По заявлению авторов, лучшие результаты среди сравниваемых методов на LIBERO-Long, RoboTwin 2.0 и DOMINO.
Почему это важно
Роботам нужна память о недавних событиях, чтобы понимать движение и прогресс задачи, но длинный контекст замедляет реакцию. Работа показывает, что дело не только в длине истории: модель должна уметь ею пользоваться, и здесь, по словам авторов, решает способ предобучения видеоосновы. Это практический ориентир для разработчиков роботов с видеомоделями мира.
Кому это важно
Исследователям робототехники и разработчикам политик управления на основе видеомоделей мира, а также тем, кто выбирает способ предобучения видеоосновы (авторегрессионный или двунаправленный) и ищет баланс между длиной контекста и задержкой.
Как это применить
Из описания видно рабочий рецепт: сначала учить причинное предсказание на видео роботов и видео от первого лица без разметки действий, затем сохранять структуру «история → будущее» при адаптации к действиям. Для скорости авторы используют потоковое кодирование наблюдений, асинхронное исполнение и ускорение под конкретное железо. Выпущены ли код, веса и данные, в тексте источника не сказано, а размер модели не указан.
Можно ли доверять
Это препринт, и все цифры, заявления самих авторов. Источник, короткая аннотация: в ней нет авторов, организаций и даты. Числовой результат 63,3% → 78,7% приведён только для RoboCasa GR-1; для LIBERO-Long, RoboTwin 2.0 и DOMINO числовых значений нет, есть лишь утверждение о лучших результатах среди сравниваемых методов. Число попыток для 95% успеха самой Long-WAM явно не названо (20 попыток указано для Pi0.5 и Fast-WAM). Независимой проверки в тексте нет.
Риски и подводные камни
Выигрыш от контекста показан в основном на одном бенчмарке числами; для остальных наборов подробности неизвестны. Задержка 107,4 мс дана только для RTX 5090, для DGX Spark и Jetson AGX Thor цифр нет. Сравнение на реальных роботах опирается на одну задачу, динамичную укладку стаканов. Утверждение, что двунаправленное предобучение не даёт выигрыша, относится к тому, что проверили авторы на RoboCasa GR-1, и не обязательно переносится на другие условия.