LiveFoley: нейросеть генерирует звук к видео в реальном времени
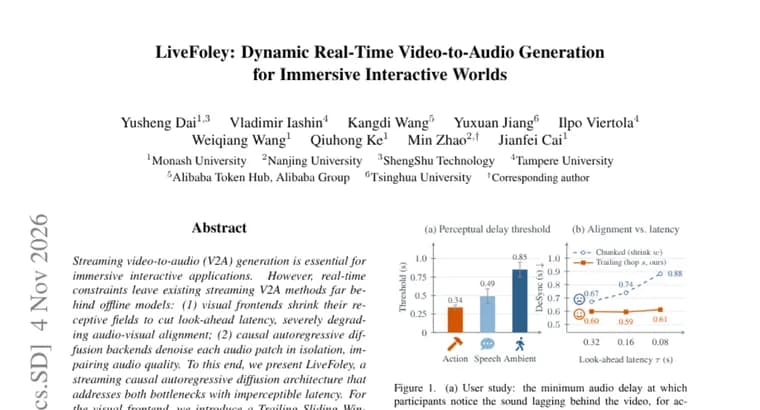
Генерация звука по видео (video-to-audio, V2A) в потоковом режиме нужна для интерактивных приложений с эффектом присутствия. Но, как пишут авторы статьи, из-за ограничений реального времени существующие потоковые методы сильно отстают от офлайн-моделей. Они называют две причины. Первая: визуальные модули сужают своё «поле зрения» по времени, чтобы уменьшить задержку на заглядывание вперёд, и из-за этого сильно страдает согласованность звука и картинки. Вторая: каузальные (то есть опирающиеся только на уже известное) авторегрессионные диффузионные модули обрабатывают каждый фрагмент звука изолированно, что ухудшает качество аудио.
В ответ авторы представляют LiveFoley, потоковую каузальную авторегрессионную диффузионную архитектуру, которая, по их словам, решает обе проблемы с незаметной для человека задержкой.
Для визуальной части предложено «скользящее окно позади» (Trailing Sliding Window). Оно превращает некаузальные кодировщики, работающие по целым сегментам видео, в потоковые модули без дообучения. Простым смещением окна сохраняется точная согласованность звука и видео, а настраиваемый шаг смещения (hop size) снижает опережение визуальной части существенно ниже порога человеческого восприятия. Опираясь на этот настраиваемый шаг, авторы предлагают Unified Varhop Framework, единую схему для сценариев с разными бюджетами по задержке и вычислениям.
Для аудиочасти исследуется расширение окна шумоподавления у локальной диффузионной трансформерной «головы» (LocDiT) в двух временных направлениях. Вариант History LocDiT добавляет контекст из прошлого: качество растёт без прибавки к задержке, и этот вариант выбран по умолчанию. Вариант Future-Warmup LocDiT использует приближённое условие из будущего, чтобы разорвать «авторегрессионный тупик». Это ещё сильнее улучшает качество, но ценой допустимого опережения на стороне аудиочасти.
По заявлению авторов, обширные эксперименты показывают: LiveFoley сравнима с офлайн-моделями по временно́й согласованности и опережает потоковые системы по качеству генерации. В аннотации нет конкретных чисел, метрик и названий тестов. Страница проекта: https://dalision.github.io/livefoley-page/
Ключевые факты
- LiveFoley, потоковая каузальная авторегрессионная диффузионная архитектура для генерации звука по видео в реальном времени.
- Trailing Sliding Window превращает некаузальные сегментные кодировщики в потоковые без дообучения; настраиваемый шаг смещения снижает опережение ниже порога человеческого восприятия.
- Unified Varhop Framework рассчитан на сценарии с разными бюджетами по задержке и вычислениям.
- В аудиочасти два варианта LocDiT: History (контекст из прошлого, без прибавки к задержке, вариант по умолчанию) и Future-Warmup (приближённое условие из будущего, лучше качество, но есть допустимое опережение).
- Авторы заявляют, что LiveFoley на уровне офлайн-моделей по временно́й согласованности и лидирует среди потоковых систем по качеству; конкретных цифр в аннотации нет.
Почему это важно
Потоковая генерация звука по видео нужна для интерактивных сред, где картинка появляется на ходу и звук нельзя досчитывать потом. Авторы отмечают, что потоковые методы пока сильно отстают от офлайн-моделей, и предлагают архитектуру, которая, по их заявлению, закрывает этот разрыв по синхронизации и обгоняет другие потоковые системы по качеству.
Кому это важно
Исследователям генерации аудио и видео, а также тем, кто строит интерактивные приложения с эффектом присутствия, где звук к видео нужен без заметной задержки. Конкретные области применения в аннотации не названы.
Как это применить
Практических данных для внедрения в аннотации нет: не указаны размер модели, требования к оборудованию и значение шага смещения. Есть ссылка на страницу проекта (https://dalision.github.io/livefoley-page/). Идея Trailing Sliding Window подаётся как способ превратить готовые сегментные кодировщики в потоковые без переобучения, а выбор между вариантами LocDiT, как компромисс между качеством и допустимым опережением.
Можно ли доверять
Все выводы здесь, утверждения самих авторов. В аннотации нет чисел, метрик, названий наборов данных и сравниваемых моделей, поэтому заявление о паритете с офлайн-моделями и лидерстве среди потоковых систем проверить по этому тексту нельзя. Нужно смотреть полный текст статьи.
Риски и подводные камни
Задержка описана лишь как «ниже порога человеческого восприятия», без значений в миллисекундах. Вариант Future-Warmup LocDiT улучшает качество ценой дополнительного опережения на стороне аудиочасти, так что компромисс между качеством и задержкой остаётся. Вычислительные требования в аннотации не указаны.