Как нейросети узнают порядок слов: разбор позиционных эмбеддингов от GPT-2 до RoPE
Автор рассылки magazine.sebastianraschka.com опубликовал длинный технический разбор того, как большие языковые модели (LLM) кодируют и обрабатывают информацию о позиции токена. Материал обещает пройти путь от классических способов до современных, включая RoPE, на наглядных схемах, с небольшой математикой и короткой реализацией на PyTorch. В конце статьи автор разбирает, как современные архитектуры используют явное позиционное кодирование или обходятся без него; в начале даётся обзор выбора таких методов в открытых моделях 2026 года.
Зачем автор взялся за тему, которую сам называет довольно мелким строительным блоком: он готовил статью о главных архитектурных трендах LLM этого года и понял, что позиционным методам не посвятил ни одного материала. Чтобы не раздувать ту статью, он вынес тему в отдельный текст. Кроме того, читатели годами просили руководство по относительным позиционным эмбеддингам (RoPE) как продолжение разговора об обучаемых абсолютных эмбеддингах из GPT. Текст рассчитан на тех, кто знаком с базовой архитектурой LLM и вектором запроса, ключа и значения в механизме внимания; автор честно предупреждает, что статья очень техническая и, возможно, слишком подробная для некоторых, а следующая вернётся к более лёгкому стилю.
Раздел 1 показывает, где позиция входит в модель. Токенизатор превращает текст в идентификаторы токенов, слой эмбеддингов сопоставляет каждому вектор признаков, блоки трансформера меняют эти векторы с помощью внимания и полносвязных слоёв, а выходной слой выдаёт оценки для следующего токена. GPT-2 (относительно классическая модель) добавляет вектор позиции к эмбеддингу каждого токена до первого блока трансформера. MiniMax-M3 (более свежая модель этого года, взятая как представитель большинства новых) добавляет позиционную информацию в каждом блоке с помощью метода RoPE внутри внимания.
Почему позиция вообще нужна, автор объясняет на двух предложениях: «The red fox jumps over the gray fox» и «The gray fox jumps over the red fox». Перестановка слов меняет смысл, но одинаковые слова получают одинаковые идентификаторы и эмбеддинги независимо от места. Если взять обычное самовнимание без позиционного кодирования и без каузальной маски, перестановка любых двух слов даст те же эмбеддинги и оценки внимания для каждой пары токенов. У GPT-подобных моделей каузальная маска ограничивает каждый токен собой и предыдущими, и это уже даёт неявную информацию о порядке: теоретически такая модель может отличить два предложения даже без явных позиционных эмбеддингов (к этой идее, называемой NoPE, автор обещает вернуться). Но маска не различает расстояние в одну позицию и в десять, поэтому явные позиционные методы остаются полезными, а то и необходимыми, и их используют GPT-2 и большинство новых LLM.
Раздел 2.1 посвящён обучаемым абсолютным позиционным эмбеддингам в GPT-2. Модель во время обучения учит таблицу векторов позиций; она устроена так же, как слой эмбеддингов токенов, с теми же размерностями, а векторы складываются поэлементно. Метод называется абсолютным, потому что вектор позиции зависит только от номера позиции m самого токена. Два слова «fox» из примера (позиции 2 и 7) получают один и тот же эмбеддинг токена, но разные векторы позиции, и потому входят в первый блок уже с разными значениями. В учебном примере для позиции 0 эмбеддинг токена [1, 1, 1] плюс вектор позиции [1.1, 1.2, 1.3] даёт [2.1, 2.2, 2.3]; значения нарисованы для простоты, в реальной модели обе таблицы инициализируются малыми случайными числами и обучаются.
У подхода есть ограничение: в исходной реализации GPT-2 1024 обучаемых вектора позиции, то есть модель работает со входом не длиннее 1024 токенов. Таблица обучается как любой слой, поэтому длину контекста нужно выбрать до начала обучения, а расширять её дорого. У GPT-2 Medium слой позиционных эмбеддингов составляет всего 0,30% весов при 1024 позициях, но при увеличении контекста до распространённых сегодня порядка 100 тысяч токенов он занял бы более 22% всех весов модели, что автор называет неэкономичным.
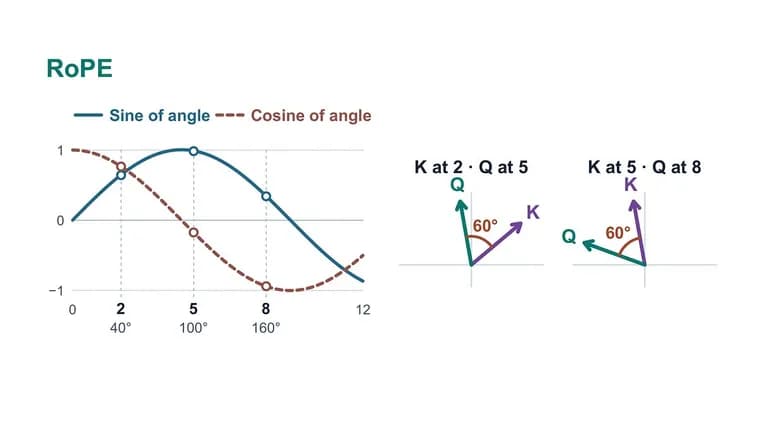
Раздел 2.2 переходит к исходному трансформеру из статьи «Attention Is All You Need» (2017), появившемуся раньше GPT. Он тоже складывает векторы, но вычисляет векторы позиций фиксированными функциями синуса и косинуса, и добавляет их перед стеками кодировщика и декодировщика. Эти функции снова понадобятся при разборе RoPE. Кроме того, исходный трансформер перед сложением умножает эмбеддинги токенов на √(dmodel), где dmodel, ширина эмбеддинга. Дальше по плану идут механика RoPE и сравнение выбора позиционных методов в современных архитектурах.
Ключевые факты
- GPT-2 добавляет к эмбеддингу каждого токена обучаемый вектор позиции до первого блока трансформера; MiniMax-M3 вместо этого применяет RoPE внутри внимания в каждом блоке.
- Каузальная маска даёт модели неявную информацию о порядке токенов, но не различает расстояние в одну позицию и в десять, поэтому явные позиционные методы полезны или даже необходимы.
- В исходной реализации GPT-2 1024 обучаемых вектора позиции: больше 1024 токенов на входе модель не принимает, а длину контекста нужно задать до обучения.
- Слой позиционных эмбеддингов у GPT-2 Medium занимает 0,30% весов при 1024 позициях; при гипотетическом контексте около 100 тысяч токенов он занял бы более 22% весов.
- Исходный трансформер 2017 года использует фиксированные синусоидальные векторы позиций и умножает эмбеддинги токенов на √(dmodel); синус и косинус затем понадобятся при разборе RoPE.
Почему это важно
Позиционное кодирование, небольшой, но обязательный узел любой LLM: без информации о порядке слов «красная лиса прыгает через серую» и «серая лиса прыгает через красную» были бы неразличимы для самовнимания без каузальной маски. Автор отмечает, что именно выбор позиционного метода связан с длиной контекста: обучаемая таблица GPT-2 жёстко фиксирует её и при контексте порядка 100 тысяч токенов стала бы неэкономичной, а потому разбор переходит к подходам, которые используют современные модели, включая RoPE в MiniMax-M3. Сам текст не сообщает новых результатов, это учебный фундамент для будущей статьи автора о трендах архитектур LLM.
Кому это важно
Тем, кто изучает устройство LLM и уже знаком с базовой архитектурой трансформера и механизмом запроса, ключа и значения. Автор рекомендует материал как продолжение своей книги Build a Large Language Model (From Scratch) и советует освежить самовнимание по его же отдельному разбору. Для тех, кто с позиционными эмбеддингами уже знаком, он предлагает сразу перейти к разделу 6 о выборе методов в современных архитектурах. Автор прямо предупреждает, что текст очень технический и может показаться слишком подробным.
Как это применить
Разбор сопровождается наглядными схемами, небольшой математикой и короткой реализацией на PyTorch. В приведённом отрывке кода GPT-2 слой позиционных эмбеддингов устроен как слой эмбеддингов токенов с теми же размерностями, а на входе векторы складываются: x = tok_embeds + pos_embeds. Читать материал автор советует в веб-версии, где слева есть панель навигации, а не в почтовом клиенте. Для проверки понимания полезно вычислить на примере из статьи, чем различаются входы двух слов «fox» на позициях 2 и 7.
Можно ли доверять
Это авторский учебный текст, а не исследование с измерениями: в доступной части нет сравнений методов и оценок качества моделей. Числа о 1024 позициях, 0,30% и более 22% весов для GPT-2 Medium приведены как расчёты автора, причём значение более 22% относится к гипотетическому контексту порядка 100 тысяч токенов, а не к реальной модели. Значения в примере с вектором [2.1, 2.2, 2.3] иллюстративные. Разбор механики RoPE и перечень методов в открытых моделях 2026 года в доступной части не раскрыты, поэтому утверждений о конкретных моделях сверх MiniMax-M3 здесь нет.
Риски и подводные камни
Материал рассчитан на подготовленного читателя: без понимания самовнимания и векторов запроса, ключа и значения часть выкладок будет сложно воспринять. Не стоит путать абсолютный метод (вектор зависит от номера позиции токена) с относительным, к которому относится RoPE. Утверждение о том, что каузальная модель теоретически различает порядок и без явных позиционных эмбеддингов, сформулировано автором осторожно, как возможность, и не означает, что явное кодирование не нужно: большинство новых LLM его используют. Наконец, обучаемая таблица позиций ограничивает длину входа и дорого масштабируется, что и мотивирует альтернативы.