Jeveration генерирует картинку за один проход: 512x512 за 78 мс
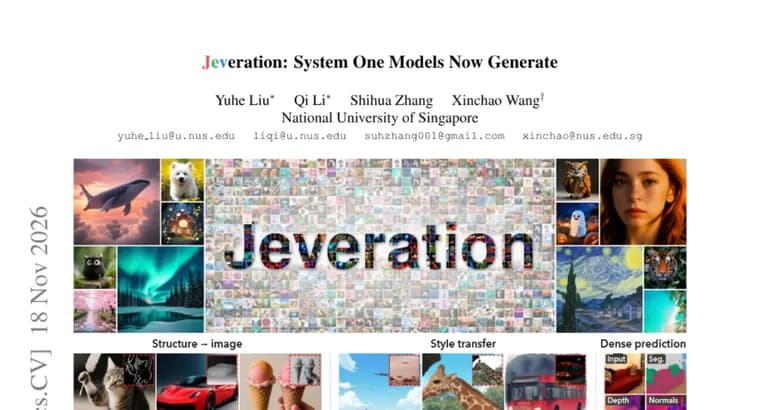
В статье представлен метод Jeveration, который генерирует изображения за один прямой проход (single forward pass) нейросети. Отправная точка, «модели Системы 1» (System One), такие как Jev: они выдают решения быстрым параллельным предсказанием. Авторы показывают, что та же парадигма годится и для генерации качественных изображений.
Jeveration строится на замороженной визуально-языковой модели: её веса не переобучаются, а накопленные визуально-семантические знания используются заново для целостной генерации картинки.
Главная трудность, как её формулируют авторы, глобальная согласованность. Один текстовый запрос допускает множество подходящих изображений, а параллельные предсказания во всех позициях должны сойтись в единое связное целое. Для этого все позиции обуславливают на общее случайное состояние: оно координирует параллельные предсказания, так что каждый новый розыгрыш даёт другое, но цельное изображение. Но при прямом обучении на изображениях модель склонна это состояние игнорировать. Поэтому авторы сначала обучают распределение по дискретным кодам изображения, которое направляет генерацию за один проход.
Помимо генерации по тексту, в ту же архитектуру встроены генерация «изображение в изображение» и плотное предсказание (dense prediction). Один чекпойнт (набор весов) поддерживает все три задачи, и каждая решается за один прямой проход.
По результатам экспериментов, Jeveration создаёт изображение 512x512 за 78 мс, при этом до 122 раз быстрее существующих унифицированных моделей. Качество изображений и результаты плотного предсказания авторы описывают как конкурентные, то есть не как превосходящие, а как сопоставимые при большей скорости.
Ключевые факты
- Jeveration генерирует изображение 512x512 за 78 мс одним прямым проходом.
- Скорость заявлена как «до 122 раз» выше, чем у существующих унифицированных моделей; это максимальная оценка.
- Метод опирается на замороженную визуально-языковую модель и общее случайное состояние для всех позиций, чтобы параллельные предсказания давали связное изображение.
- Один чекпойнт решает три задачи: генерацию по тексту, генерацию «изображение в изображение» и плотное предсказание.
- Качество изображений и плотного предсказания авторы называют конкурентным, а не лучшим.
Почему это важно
Обычно генерация изображений, многошаговый процесс, и скорость упирается в число проходов по модели. Здесь заявлен один проход: 512x512 за 78 мс. Если результат подтвердится независимыми замерами, это приблизит генерацию картинок к режиму реального времени. Отдельный интерес, повторное использование замороженной визуально-языковой модели: её знания применяются для генерации без полного переобучения.
Кому это важно
Исследователям генеративных моделей и унифицированных мультимодальных архитектур, а также тем, кого интересует быстрый вывод (инференс) картинок. Практический интерес для разработчиков появится, когда станут известны детали реализации и условия замеров.
Как это применить
Прямого применения пока нет: в тексте не упоминаются выпуск кода, весов или чекпойнта. Сейчас работу полезно читать как идею: параллельное предсказание всех позиций плюс общее случайное состояние для согласованности и предварительно обученное распределение по дискретным кодам изображения.
Можно ли доверять
Это заявления самих авторов из описания статьи. В тексте не названы авторы и организации, не указано, на каком оборудовании измерены 78 мс и какие именно модели сравнивались. Цифра 122x, максимум («до»), а не типичный выигрыш. Метрики качества (например, FID или GenEval) и результаты плотного предсказания в тексте не приведены, есть лишь слово «конкурентное». Независимой проверки в источнике нет.
Риски и подводные камни
Скорость измерена для разрешения 512x512, и данных о больших разрешениях в источнике нет. Сравнение «до 122 раз», лучший случай и не отражает разницу со всеми моделями. Авторы сами отмечают, что модель склонна игнорировать общее случайное состояние при прямом обучении на изображениях, поэтому им пришлось вводить промежуточное обучение распределения по дискретным кодам, что усложняет метод. Ключевая задача, по их словам, глобальная согласованность изображения.
«Ключевая трудность, сохранить глобальную согласованность.»
— из описания статьи о Jeveration