JEV поднял Qwen2.5-1.5B над GRPO: слабый исполнитель может хорошо учить
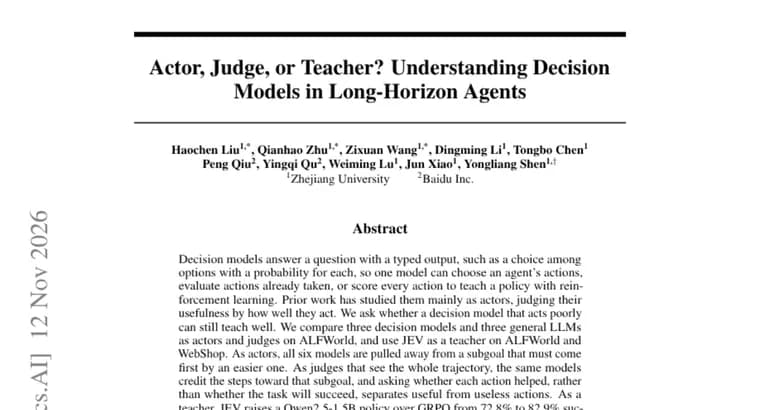
В аннотации препринта на Hugging Face Papers рассматриваются «решающие модели» (decision models): они отвечают на вопрос структурированным ответом, например выбором из вариантов с вероятностью для каждого. Поэтому одна и та же модель может выбирать действия агента, оценивать уже совершённые действия или оценивать каждое действие, чтобы обучать политику с помощью обучения с подкреплением. По словам авторов, раньше такие модели изучали в основном как исполнителей и судили об их полезности по тому, насколько хорошо они действуют.
Авторы задают другой вопрос: может ли модель, которая плохо действует, всё же хорошо учить? Они сравнивают три решающие модели и три универсальные большие языковые модели (всего шесть) в ролях исполнителя и судьи на ALFWorld, а затем используют JEV как учителя на ALFWorld и WebShop.
В роли исполнителя все шесть моделей отвлекаются от подцели, которую нужно выполнить первой, на более простую. В роли судьи, который видит всю траекторию целиком, те же модели засчитывают шаги к этой подцели. Кроме того, вопрос «помогло ли каждое действие», а не «завершится ли задача успехом», позволяет отделить полезные действия от бесполезных.
В роли учителя JEV поднимает политику Qwen2.5-1.5B относительно GRPO с 72,8% до 82,9% успеха на ALFWorld и с 56,8% до 71,4% на WebShop. Из этого авторы делают осторожный вывод (формулировка «suggest», то есть «позволяют предположить»): слабый исполнитель может хорошо учить, потому что оценка действия после окончания эпизода раскрывает последствия, которые при действии приходится предвидеть. Код опубликован на GitHub: ZJU-REAL/decision-agents.
Ключевые факты
- Решающие модели выдают структурированный ответ (например, выбор из вариантов с вероятностями), поэтому одна модель может выбирать действия, оценивать совершённые или оценивать каждое действие для обучения политики.
- Сравнивались три решающие модели и три универсальные большие языковые модели в ролях исполнителя и судьи на ALFWorld.
- Как исполнители все шесть моделей отвлекаются от подцели, которую нужно выполнить первой, на более лёгкую; как судьи, видящие всю траекторию, они засчитывают шаги к этой подцели.
- Вопрос «помогло ли действие» вместо «будет ли задача решена» лучше отделяет полезные действия от бесполезных.
- JEV как учитель поднимает политику Qwen2.5-1.5B относительно GRPO: на ALFWorld с 72,8% до 82,9% успеха, на WebShop с 56,8% до 71,4%.
Почему это важно
Обычно модель принятия решений оценивают по тому, как хорошо она сама действует. Работа предлагает смотреть на неё и как на оценщика: даже если модель плохо выбирает действия, оценка уже совершённых действий может давать полезный сигнал для обучения. Это пригодится тем, кто обучает агентов на длинных задачах с подкреплением. На двух бенчмарках, ALFWorld и WebShop, это выразилось в заметном росте успеха небольшой политики Qwen2.5-1.5B относительно GRPO.
Кому это важно
Исследователям агентов и обучения с подкреплением для языковых моделей, а также командам, которые обучают небольшие модели на длинных многошаговых задачах и ищут способы оценивать отдельные действия, а не только итог эпизода.
Как это применить
Код опубликован на GitHub (ZJU-REAL/decision-agents), так что результаты можно проверить и повторить. Практическая идея из аннотации: при оценке шагов спрашивать, помогло ли каждое действие, а не будет ли успешной вся задача. Что именно означает JEV и как он устроен, в аннотации не сказано, поэтому детали стоит смотреть в самой статье и репозитории.
Можно ли доверять
Это препринт, представленный через Hugging Face Papers, и пересказ опирается только на его аннотацию. Авторы и их организации в тексте аннотации не названы. Числа успеха абсолютные, указаны для одного размера политики (Qwen2.5-1.5B) и двух бенчмарков. Число запусков, доверительные интервалы и статистическая значимость не приведены, а эксперименты с исполнителем и судьёй описаны только качественно. Код открыт, это упрощает проверку.
Риски и подводные камни
Результаты ограничены ALFWorld и WebShop и одной моделью-политикой Qwen2.5-1.5B; об остальных моделях и бенчмарках аннотация ничего не утверждает. Вывод о том, что слабый исполнитель может хорошо учить, сформулирован авторами как предположение. В аннотации не названы три решающие модели и три универсальные модели, не объяснено, что такое JEV, и не указаны затраты на обучение, поэтому перенос выводов на другие условия требует отдельной проверки.
«Эти результаты позволяют предположить, что слабый исполнитель всё же может хорошо учить, потому что оценка действия после окончания эпизода раскрывает последствия, которые необходимо предвидеть при действии.»
— аннотация препринта «Actor, Judge, or Teacher? Understanding Decision Models in Long-Horizon Agents»