IterSynth: новый ИИ-агент для глубокого поиска обошёл соперников на 4,2%
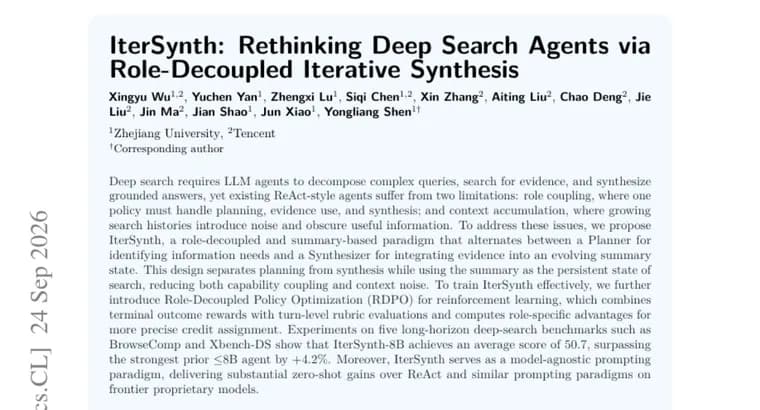
Авторы работы описывают проблему существующих поисковых агентов на базе подхода ReAct: одна и та же модель вынуждена одновременно планировать поиск, использовать найденные данные и синтезировать ответ (это называют «связанностью ролей»), а по мере роста истории поиска в контексте накапливается шум, который мешает находить нужную информацию («накопление контекста»). Чтобы решить обе проблемы, предложена архитектура IterSynth, подход с разделением ролей и синтезом на основе саммари. В нём чередуются две роли: Планировщик, который определяет, какая информация ещё нужна, и Синтезатор, который встраивает найденные свидетельства в постоянно обновляемое состояние-саммари. За счёт этого планирование отделено от синтеза, а само саммари служит устойчивым «состоянием» поиска, это снижает как связанность ролей, так и шум в контексте. Для обучения такой архитектуры авторы разработали метод обучения с подкреплением Role-Decoupled Policy Optimization (RDPO), который сочетает итоговую награду за результат с пооборотными (turn-level) оценками по рубрикам и считает отдельные преимущества (advantages) для каждой роли, что даёт более точное распределение «заслуги» между шагами. В экспериментах на пяти бенчмарках для долгих сценариев глубокого поиска (в их числе BrowseComp и Xbench-DS) версия IterSynth-8B показала средний результат 50,7 балла, превысив лучшего из прежних агентов размером до 8 миллиардов параметров на 4,2 процентных пункта. Кроме того, авторы утверждают, что IterSynth работает и как модель-агностичный подход к построению запросов (prompting): применённый к передовым проприетарным моделям без дообучения (zero-shot), он даёт существенный прирост по сравнению с ReAct и похожими схемами запросов.
Ключевые факты
- IterSynth разделяет роли ИИ-агента на Планировщика (определяет, что искать) и Синтезатора (собирает найденное в саммари), в отличие от единой модели в схеме ReAct
- Новый метод обучения с подкреплением RDPO сочетает награду за итоговый результат с пооборотными оценками по рубрикам и считает отдельный вклад для каждой роли
- На пяти бенчмарках глубокого поиска (включая BrowseComp и Xbench-DS) версия IterSynth-8B набрала в среднем 50,7 балла, на 4,2 процентных пункта больше лучшего прежнего агента до 8 млрд параметров
- Подход заявлен как модель-агностичный: применение его схемы запросов к передовым проприетарным моделям без дообучения также даёт заметный прирост по сравнению с ReAct
- Авторские данные и институты, дата публикации, детали архитектуры и объём обучающих данных в тексте не указаны
Почему это важно
Поисковые ИИ-агенты, одно из самых практичных применений LLM, но у стандартной схемы ReAct есть известные слабые места: одна модель одновременно планирует, оценивает найденное и формулирует ответ, а с ростом истории поиска в контексте накапливается шум. IterSynth предлагает архитектурное решение, развести роли и вынести накопленное знание в отдельное обновляемое саммари вместо разрастающейся истории диалога.
Кому это важно
Разработчикам агентных систем и поисковых ассистентов на базе LLM, а также исследователям, работающим над методами обучения с подкреплением для многошаговых агентов, RDPO предлагает конкретный способ распределять награду между разными ролями агента.
Как это применить
Авторы описывают IterSynth не только как обучаемую архитектуру (показана версия на 8 млрд параметров), но и как схему построения запросов, которую можно применить поверх готовых проприетарных моделей без дообучения, по их данным, это уже даёт прирост качества по сравнению с ReAct.
Можно ли доверять
Данные приведены только в виде среднего балла по пяти бенчмаркам и одного числа улучшения (+4,2%) без разбивки по отдельным тестам; имена авторов, их организации и дата публикации в доступном тексте не указаны, детали архитектуры и объём обучающих данных не раскрыты, независимая проверка результатов пока не известна.
Риски и подводные камни
Заявленное улучшение измерено против лучшего прежнего агента размером не более 8 млрд параметров, сравнение с более крупными или закрытыми системами не приводится. Отсутствие данных о размере обучающей выборки и вычислительных затратах затрудняет оценку воспроизводимости и практической стоимости внедрения подхода.