Исследователи выяснили, откуда в нейросетях берётся слово «wait» при рассуждении
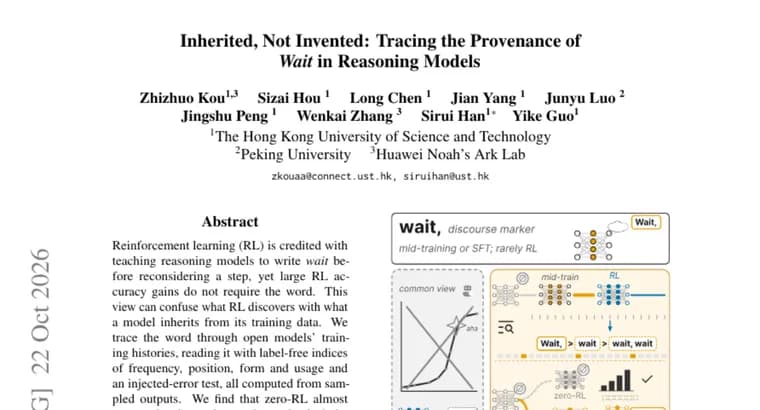
В статье с портала Hugging Face Papers разбирается популярное убеждение: считается, что обучение с подкреплением (RL) учит рассуждающие модели писать слово «wait» («подожди») перед тем, как пересмотреть шаг решения. Авторы возражают: большой прирост точности от RL не требует этого слова, а привычный взгляд, по их мнению, путает то, что RL открывает само, с тем, что модель наследует из обучающих данных.
Метод: авторы прослеживают слово по истории обучения открытых моделей. Они считывают его с помощью безразметочных показателей (частота, позиция, форма и способ употребления) и теста с внесённой ошибкой; всё вычисляется по сгенерированным моделью ответам.
Главные находки. Во-первых, обучение с подкреплением «с нуля» (zero-RL) почти никогда не порождает этот маркер: на базовых моделях, где слова нет, RL заметно повышает точность на MATH-500, а «wait» остаётся почти незаметным. Во-вторых, слово приходит вместе с данными: через промежуточное дообучение (mid-training) в OLMo-3, а дообучение на трассах рассуждений вносит его в большинство моделей, у которых в базе его не было.
В-третьих, если база уже использует это слово, оба опубликованных рецепта RL-Zero (OLMo-3 и MiMo) его многократно усиливают, а GRPO без KL-штрафа на той же базе, нет. Рецепт OLMo-3 к тому же «стирает» форму слова и делает его более чувствительным, но и более «либеральным» сигналом тревоги. RL после контролируемого дообучения (SFT) маркер почти не меняет, а рецепт GRPO самих авторов стирает маркер, внесённый дообучением.
Наконец, авторы заключают, что одной частоты маркера недостаточно, чтобы судить о рассуждении, вызванном RL, и предостерегают от метрик пересмотра на основе LLM-судьи: автоматические судьи могут развернуть тенденции, размеченные людьми, в обратную сторону.
Ключевые факты
- Считается, что RL учит модели писать «wait» перед пересмотром шага, но большой прирост точности от RL этого слова не требует.
- Zero-RL почти никогда не порождает маркер: на базах без слова RL заметно повышает точность на MATH-500, а «wait» остаётся почти незаметным.
- Слово приходит с обучающими данными: через mid-training в OLMo-3 и дообучение на трассах рассуждений в большинстве моделей, где в базе его не было.
- Если база уже использует слово, оба опубликованных рецепта RL-Zero (OLMo-3, MiMo) его умножают, а GRPO без KL-штрафа на той же базе, нет.
- Одной частоты маркера мало для суждения о рассуждении от RL; метрики пересмотра на LLM-судье могут развернуть размеченные людьми тенденции.
Почему это важно
Слова вроде «wait» часто принимают за след «самостоятельного» обучения рассуждению. Работа предлагает другое объяснение: заметную часть этого поведения модель может просто наследовать из данных. Это меняет трактовку того, что именно даёт обучение с подкреплением.
Кому это важно
Исследователям и командам, которые обучают рассуждающие модели и оценивают, что дал RL, а также тем, кто строит метрики «саморефлексии» по частоте маркеров или с помощью LLM-судьи.
Как это применить
Выводы авторов практичны для оценки: не судить о рассуждении, вызванном RL, только по частоте слова «wait», с осторожностью относиться к метрикам пересмотра на основе LLM-судьи и сверять результат с историей обучения базовой модели и данных. Сведений о выпущенном коде, данных или моделях в тексте источника нет.
Можно ли доверять
Это краткая аннотация статьи на Hugging Face Papers; пересказ опирается только на неё. Утверждения принадлежат авторам, числовых значений (точности, частот, размеров эффекта) в тексте нет, только качественные формулировки вроде «заметно» и «почти отсутствует». Оценить строгость экспериментов по этому тексту нельзя.
Риски и подводные камни
Выводы касаются прослеженных авторами открытых моделей; в аннотации названы OLMo-3 и MiMo, остальной состав не уточняется, поэтому обобщать на все модели рано. Статья не утверждает, что RL не важен для рассуждения: речь о том, что слово не обязательно для прироста точности, а его частота сама по себе ничего не доказывает.