Исследователи разобрали 143 тысячи траекторий ИИ-агентов для кода и сравнили их поведение
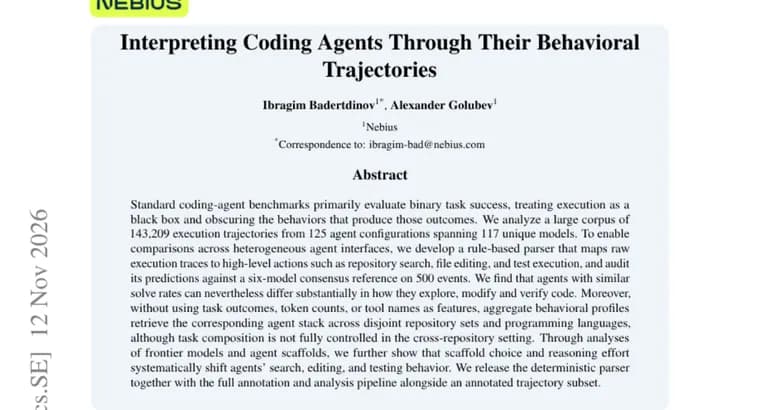
Авторы препринта исходят из того, что стандартные бенчмарки для агентов, пишущих код, в основном оценивают бинарный успех задачи. Выполнение при этом остаётся «чёрным ящиком», и поведение, которое приводит к результату, не видно.
Чтобы заглянуть внутрь, они собрали большой корпус: 143 209 траекторий выполнения от 125 конфигураций агентов, которые охватывают 117 уникальных моделей. Агентские интерфейсы устроены по-разному, поэтому для сопоставления авторы написали детерминированный парсер на правилах. Он переводит сырые трассы выполнения в высокоуровневые действия: поиск по репозиторию, редактирование файлов, запуск тестов. Предсказания парсера авторы сверили с эталоном из консенсуса шести моделей на 500 событиях.
Главный вывод: агенты с похожей долей решённых задач могут заметно отличаться тем, как они исследуют код, изменяют его и проверяют результат. Второй вывод: агрегированные поведенческие профили позволяют определить соответствующий «стек» агента на непересекающихся наборах репозиториев и на разных языках программирования. Для этого не использовались исходы задач, число токенов и названия инструментов. Авторы оговаривают, что в сценарии с разными репозиториями состав задач контролировался не полностью.
На примере передовых моделей и агентских каркасов (scaffold) авторы также показывают, что выбор каркаса и уровень рассуждений (reasoning effort) систематически сдвигают поведение агента при поиске, редактировании и тестировании.
Авторы публикуют парсер вместе с полным конвейером разметки и анализа и размеченную часть траекторий.
Ключевые факты
- Корпус: 143 209 траекторий выполнения от 125 конфигураций агентов, охватывающих 117 уникальных моделей.
- Парсер на правилах переводит сырые трассы в действия вроде поиска по репозиторию, правки файлов и запуска тестов; его проверили на 500 событиях по консенсусу шести моделей.
- Агенты с похожей долей решённых задач заметно различаются по тому, как исследуют, меняют и проверяют код.
- Поведенческие профили без исходов задач, токенов и названий инструментов позволяют определить стек агента на разных репозиториях и языках.
- Выбор каркаса и уровень рассуждений систематически сдвигают поиск, редактирование и тестирование; парсер и размеченная часть траекторий опубликованы.
Почему это важно
Бенчмарки для агентов-программистов обычно показывают лишь, решена ли задача. По словам авторов, это скрывает, как именно агент к результату пришёл. Работа предлагает смотреть на поведение: как агент ищет по репозиторию, правит файлы и запускает тесты. Вывод о том, что при сходной доле решённых задач стили работы заметно различаются, показывает: одна итоговая цифра теряет существенную часть картины.
Кому это важно
Исследователям, которые оценивают агентов для кода и строят бенчмарки. Разработчикам агентских каркасов, которым нужно понимать, как их выбор влияет на поведение. Командам, выбирающим агента для работы с кодом: два агента с близкой долей решённых задач могут по-разному исследовать, менять и проверять код.
Как это применить
Авторы выкладывают детерминированный парсер, полный конвейер разметки и анализа и размеченную часть траекторий. Их можно использовать, чтобы разобрать собственные трассы агентов по общим категориям действий и сравнить конфигурации не только по итогу, но и по поведению. Ссылка, лицензия и размер набора в тексте аннотации не указаны.
Можно ли доверять
Это препринт, и оценка опирается на аннотацию: авторы и организации в ней не названы, конкретные модели, каркасы и бенчмарки не перечислены. Точность парсера проверена на 500 событиях по консенсусу шести моделей, а числовых показателей совпадения в аннотации нет. Результат о восстановлении стека агента по профилю получен без полного контроля состава задач в сценарии с разными репозиториями, и авторы сами это оговаривают.
Риски и подводные камни
Парсер на правилах сводит трассы к фиксированному набору действий, а точность этого сведения проверена на небольшой выборке из 500 событий. В аннотации нет размера и направления эффектов каркаса и уровня рассуждений, поэтому одно лишь утверждение о «систематическом сдвиге» не позволяет судить о его величине. Различия в поведении сами по себе ничего не говорят о том, какой стиль лучше.