Исследователи представили PARTS, RL-метод, поднявший успех роботов-манипуляторов до 95%
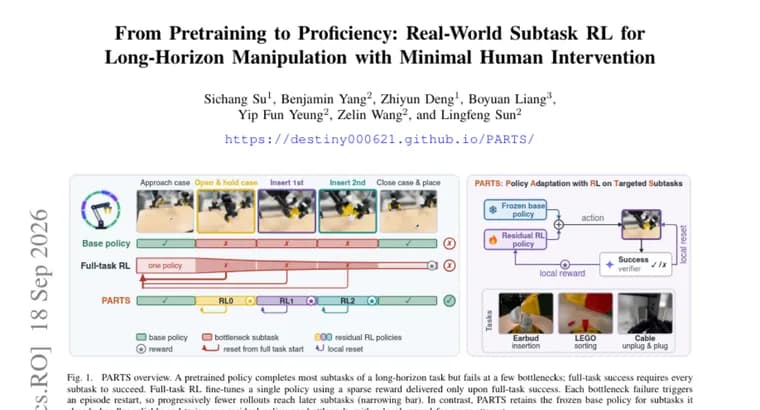
Проблема, от которой отталкиваются авторы: предобученная базовая политика робота часто выполняет большую часть длинной многошаговой задачи, но раз за разом проваливает несколько узких подзадач. Донабирать для таких случаев полные демонстрации всей задачи ради дообучения с учителем (SFT) невыгодно, оператору приходится заново повторять то, что политика и так умеет делать хорошо. Дообучение с подкреплением (RL) выглядит перспективным способом закрыть именно этот пробел, но существующие подходы плохо справляются с длинными задачами, когда награда даётся редко, только по факту полного успеха.
Авторы предложили метод PARTS (Policy Adaptation with RL on Targeted Subtasks, адаптация политики через RL на целевых подзадачах). Он сосредотачивает обучение ровно на узких местах: замороженная предобученная политика по-прежнему выдаёт основные действия на протяжении всего выполнения задачи, а поверх неё работают сгенерированные агентом селекторы и верификаторы успеха, они включают точечные корректирующие действия именно в проблемных подзадачах и выдают локальную награду за результат конкретной подзадачи. Благодаря этому политика может учиться на успешных подзадачах, даже когда успешных прохождений задачи целиком мало. Обучение сочетает онлайн-RL с переобучением, взвешенным по успеху: каждая переобученная корректирующая (остаточная) политика заново разворачивается на роботе, чтобы собрать дополнительный опыт. Участие человека сведено к минимуму, люди определяют узкие места на этапе настройки и вручную возвращают робота в исходное положение, когда это нужно между попытками.
На двуруких задачах на платформе YAM доля полностью успешных выполнений выросла с 32% до 61%. На задачах с одной рукой на платформе Franka, с 50% до 95%. В среднем на одну задачу уходят десятки минут реального RL-обучения на роботе. По сравнению с существующими методами реального RL-дообучения при одинаковом бюджете попыток робота PARTS повышает долю полностью успешных выполнений задачи более чем на 25%, и при этом требует меньше участия человека.
Ключевые факты
- PARTS дообучает уже предобученную политику робота, сосредотачиваясь именно на подзадачах, где она чаще всего проваливается, а не переобучает всю задачу целиком.
- На двуруких задачах на платформе YAM доля полностью успешных выполнений выросла с 32% до 61%.
- На задачах с одной рукой на платформе Franka, с 50% до 95%.
- Обучение занимает в среднем десятки минут реального RL на одну задачу и требует минимального участия человека, только определение узких мест и физические сбросы робота между попытками.
- При одинаковом бюджете попыток робота PARTS повышает долю полностью успешных выполнений более чем на 25% по сравнению с существующими методами реального RL-дообучения.
Почему это важно
Предобученные универсальные политики роботов, частая ситуация: робот выполняет почти всю длинную задачу правильно, но систематически спотыкается на одном-двух узких шагах. До сих пор единственным лекарством было донабирать полные демонстрации всей задачи заново, дорого и избыточно, ведь остальная часть политики и так работает. PARTS показывает способ точечно «подлатать» именно слабые места прямо на реальном роботе с помощью RL, не трогая то, что уже работает.
Кому это важно
Инженерам и исследователям, которые строят и дообучают универсальные политики роботов-манипуляторов для длинных многошаговых задач, а также командам, развёртывающим роборуки в реальных условиях, где полный сбор новых демонстраций для каждой ошибки не масштабируется.
Как это применить
Схема из работы: берётся замороженная предобученная политика; на этапе настройки человек указывает, какие подзадачи регулярно проваливаются; поверх политики обучаются лёгкие корректирующие RL-модули с автоматическими селекторами и верификаторами успеха, которые включаются только в проблемных местах и дают локальную награду за результат; каждый дообученный корректирующий модуль заново прогоняется на роботе для сбора данных; человек нужен лишь для физического возврата робота в исходное состояние между попытками. Источник не называет ни цену, ни лицензию, ни конкретный срок публикации, эти детали в пересказ не добавлены.
Можно ли доверять
Источник, карточка препринта на HuggingFace Papers с полным текстом аннотации; в самом тексте не указаны ни имена авторов, ни организации, ни площадка публикации. Все цифры, 32%→61%, 50%→95%, «более 25%», взяты дословно из аннотации и являются самоотчётом авторов на их собственных бенчмарках (двурукая платформа YAM и однорукая Franka), без независимой проверки третьей стороной.
Риски и подводные камни
Метод не полностью автономен: человек всё равно нужен, чтобы на этапе настройки указать узкие подзадачи и чтобы физически сбрасывать робота между попытками обучения. Результаты показаны только на двух конкретных платформах и наборах задач, обобщение на другие роботы и типы манипуляций не подтверждено. Точный объём затраченного времени и бюджета попыток робота в тексте не раскрыт, указаны лишь «десятки минут» в среднем на задачу, без разбивки по задачам и без данных о воспроизводимости независимыми группами.