Исследователи представили GenV, способ ловить скрытые ошибки автоформализации в ИИ
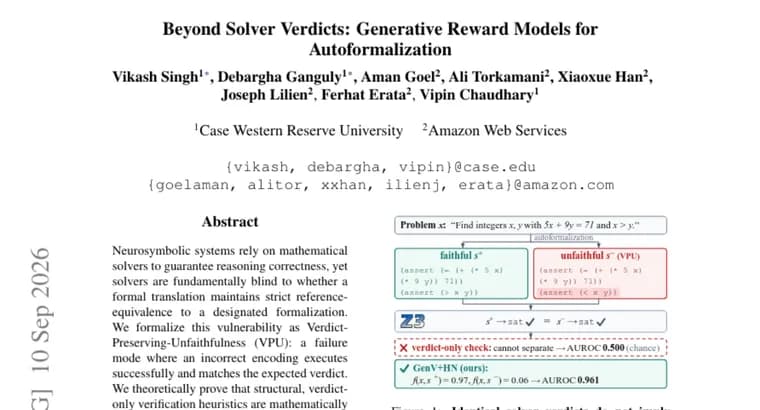
Нейросимволические системы совмещают языковые модели с математическими решателями (например, Z3), чтобы гарантировать корректность рассуждений: модель переводит задачу в формальный вид, а решатель проверяет итоговый вердикт. Авторы работы показывают, что у этой схемы есть слепое пятно, решатель проверяет только конечный вердикт, но не то, действительно ли формальный перевод точно соответствует исходной, эталонной формулировке задачи. Это позволяет ошибочному переводу случайно "попасть" в правильный вердикт и пройти проверку незамеченным. Авторы формализуют такой сбой как Verdict-Preserving-Unfaithfulness (VPU, сохранение вердикта при недостоверном переводе) и теоретически доказывают, что эвристики проверки, опирающиеся только на структуру и итоговый вердикт, математически не способны ловить такие случаи лучше, чем случайное угадывание.
Чтобы решить проблему, авторы предлагают Generative Verification (GenV), метод, который дистиллирует офлайновый оракул на основе эквивалентности Z3 в непрерывную оценку соответствия эталонной формализации, переиспользуя для этого словарное пространство самой языковой модели, а не отдельный внешний классификатор. Анализ через логит-линзы (logit lens) и разреженные автоэнкодеры показывает, что такой генеративный механизм сам, без отдельного обучения на задаче локализации, извлекает точные координаты места ошибки в формальной записи.
В экспериментах верификатор, обученный на данных, размеченных этим оракулом (GenV+HN), достигает 0,961 AUROC при проверке соответствия эталону, обобщается в режиме zero-shot на незнакомые модели-переводчики и на другие стили формальной записи, которых не было в обучении, и даёт прирост точности на 11,3 процентного пункта в задаче агентного распределения вычислений на этапе применения модели (test-time compute allocation).
Ключевые факты
- Решатели (например, Z3) в нейросимволических системах проверяют только итоговый вердикт, но не то, точно ли формальный перевод соответствует эталонной формулировке задачи, это слепое пятно авторы называют Verdict-Preserving-Unfaithfulness (VPU)
- Авторы теоретически доказывают: эвристики проверки, опирающиеся только на структуру и вердикт, не могут ловить такие ошибки лучше случайного угадывания
- Метод GenV дистиллирует офлайновый оракул на основе эквивалентности Z3 в непрерывную оценку соответствия эталону, используя словарное пространство самой языковой модели
- Анализ через логит-линзы и разреженные автоэнкодеры показывает: механизм GenV сам находит точные координаты ошибки в формальной записи без отдельного обучения локализации
- Верификатор GenV+HN даёт 0,961 AUROC, переносится zero-shot на новые модели-переводчики и стили формализации и повышает точность на 11,3 процентного пункта в задаче агентного распределения вычислений
Почему это важно
Нейросимволические системы (LLM плюс формальный решатель) используют именно потому, что решатель должен давать математическую гарантию корректности, там, где одной языковой модели верить нельзя. Эта работа показывает, что гарантия неполная: решатель видит только итоговый вердикт, а не то, честно ли переведена сама задача. Ошибочный, но "удачно" совпавший по вердикту перевод проходит проверку, и вся конструкция, которая должна была устранить недоверие к LLM, наследует именно тот тип скрытой ошибки, от которого её строили защищать.
Кому это важно
Тем, кто разрабатывает и использует нейросимволические системы: автоформализацию математических и логических задач, автоматическое доказательство теорем, формальную верификацию кода и агентные системы, которые полагаются на решатели как на источник гарантированно корректных промежуточных шагов. Актуально и для исследователей интерпретируемости моделей, метод построен на анализе внутренних представлений языковой модели (логит-линзы, разреженные автоэнкодеры).
Как это применить
GenV задуман как дополнительный слой проверки поверх существующего пайплайна "перевод в формальный вид → решатель": оракул на основе эквивалентности Z3 размечает данные офлайн, а обученный на них верификатор (GenV+HN) затем оценивает новые переводы без обращения к дорогому оракулу на каждом шаге. Ключевое практическое свойство из статьи, перенос без дообучения (zero-shot) на модели-переводчики и стили формализации, которые не встречались при обучении верификатора, то есть его не обязательно переобучать под каждый новый источник формальных переводов.
Можно ли доверять
Источник, карточка препринта на Hugging Face Papers, и сам текст аннотации не называет авторов, организации, дату, площадку публикации и статус рецензирования, это отсутствует в тексте, а не скрыто нами. Указанное в карточке HF имя (Vikash Singh), это, судя по всему, тот, кто добавил статью на площадку, а не обязательно автор работы, поэтому в пересказе оно не используется как атрибуция. Все цифры (0,961 AUROC, +11,3 процентного пункта), это заявленные авторами результаты их же экспериментов, без независимой проверки в доступном тексте. Расшифровка аббревиатуры "HN" в названии GenV+HN в аннотации не приведена.
Риски и подводные камни
В доступном тексте нет данных о том, на каких именно моделях, наборах данных и в какой предметной области получены 0,961 AUROC и +11,3 процентного пункта, это ограничивает возможность оценить, насколько результат обобщается за пределами экспериментов авторов. Сам метод обучается по разметке, полученной от оракула на основе эквивалентности Z3: если этот оракул сам допускает системные ошибки на каких-то классах задач, верификатор, скорее всего, унаследует их. Заявленный перенос без дообучения на "незнакомые модели-переводчики и стили", тоже результат из той же работы, без стороннего подтверждения.