Исследователи предложили LoHi: как ускорить анализ длинных видео нейросетью и поднять точность
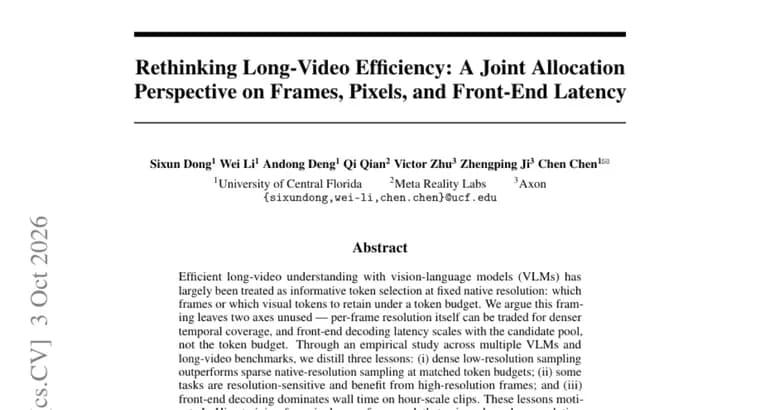
Авторы статьи, опубликованной в разделе Hugging Face Papers, пересматривают подход к эффективному анализу длинных видео в мультимодальных нейросетях (VLM, моделях, которые работают с видео и текстом). Обычно задачу формулируют как выбор информативных кадров или визуальных токенов при фиксированном «родном» разрешении. Авторы показывают, что разрешение каждого кадра можно обменять на более плотный охват по времени, а задержка на стадии декодирования видео (front-end) зависит от размера пула кандидатов, а не от итогового бюджета токенов.
Эмпирическое исследование на нескольких VLM и бенчмарках для длинных видео дало три вывода. Во-первых, плотная выборка кадров низкого разрешения превосходит редкую выборку в родном разрешении при одинаковом бюджете токенов. Во-вторых, задачи, чувствительные к разрешению, выигрывают от отдельных кадров высокого разрешения. В-третьих, для часовых видео именно декодирование на входе занимает основную часть времени работы.
На этой основе авторы предлагают LoHi, не требующий обучения однопроходный фреймворк. Он объединяет плотный видеопоток низкого разрешения с редкими изображениями высокого разрешения и подаёт их через штатные «видео-» и «картиночный» каналы самой VLM. Предложено два способа отбора кадров высокого разрешения: LoHi-Anchor использует метаданные I-кадров кодека, а LoHi-SemDiv опирается на релевантность запросу и визуальное разнообразие по признакам CLIP.
По заявлению авторов, на трёх бенчмарках для длинных видео LoHi повышает среднюю точность на 10,6 процентного пункта относительно базового варианта в родном разрешении при том же бюджете токенов и на 5,2 процентного пункта относительно сильнейшего из прежних методов повышения эффективности. Кроме того, задержка декодирования на входе снижается до 7 раз на часовых видео. В тексте даётся ссылка на страницу проекта.
Ключевые факты
- LoHi, не требующий обучения однопроходный фреймворк: плотный видеопоток низкого разрешения плюс редкие кадры высокого разрешения через штатные каналы VLM.
- Два способа отбора кадров: LoHi-Anchor (метаданные I-кадров кодека) и LoHi-SemDiv (релевантность запросу и разнообразие по признакам CLIP).
- Средняя точность на трёх бенчмарках для длинных видео выше на 10,6 п.п. базового варианта в родном разрешении при том же бюджете токенов и на 5,2 п.п. сильнейшего прежнего метода.
- Задержка декодирования на входе снижается до 7 раз на часовых видео.
- Исследование показало: при одинаковом бюджете токенов плотная выборка низкого разрешения лучше редкой в родном разрешении, а декодирование доминирует по времени на часовых видео.
Почему это важно
Анализ часовых видео нейросетями упирается и в точность, и в время. Работа предлагает смотреть на проблему целиком: распределять между кадрами, пикселями и задержкой на входе, а не только выбирать «лучшие» кадры. По утверждению авторов, при том же бюджете токенов выгоднее брать больше кадров в низком разрешении.
Кому это важно
Разработчикам и исследователям, которые строят системы понимания длинных видео на базе VLM: поиск по записям, разбор лекций, длинных роликов, архивов. Идея не требует дообучения, поэтому её можно применять к уже существующим моделям.
Как это применить
Согласно описанию, LoHi работает поверх штатных видео- и картиночного входов VLM: основной поток подаётся как видео низкого разрешения, а несколько выбранных кадров, как изображения высокого разрешения. Для выбора кадров есть два варианта: по метаданным I-кадров кодека или по релевантности запросу и разнообразию на признаках CLIP. Ссылка на страницу проекта указана в источнике; сведений о лицензии, коде и весах в тексте нет.
Можно ли доверять
Это только аннотация препринта в разделе Hugging Face Papers. Все цифры, заявления авторов; в аннотации не названы ни бенчмарки, ни протестированные модели, ни бюджет токенов, ни разрешения. Приросты 10,6 и 5,2, средние абсолютные значения в процентных пунктах по трём бенчмаркам, а не относительные улучшения и не результаты по отдельным тестам. Ускорение «до 7 раз», верхняя граница для часовых видео, типичное значение не указано.
Риски и подводные камни
Без полного текста нельзя оценить, насколько результаты воспроизводимы и на каких моделях и данных получены. Ограничения и случаи, где метод не работает, в аннотации не описаны. Ускорение указано только для часовых видео и как максимум, поэтому на коротких роликах выигрыш по задержке может быть другим.