Исследователи подняли точность ИИ на редких сущностях на 23,3% за счёт рассуждений и поиска по Википедии
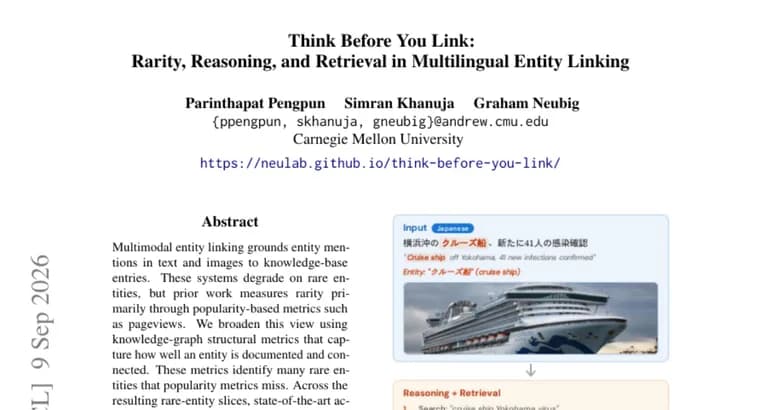
Авторы опубликовали исследование о мультимодальном связывании сущностей, задаче, где упоминание в тексте и на изображении нужно сопоставить с конкретной записью в базе знаний. Такие системы плохо справляются с редкими сущностями, но до сих пор редкость определяли в основном по популярности, например, по числу просмотров страницы в Википедии. Авторы предложили другой подход: измерять редкость через структурные метрики графа знаний, насколько подробно и насколько плотно сущность описана и связана с другими. Эти метрики находят много редких сущностей, которые метрики по популярности пропускают, и на таких срезах точность современных систем падает на 15,4, 39,9%.
Чтобы исправить это, авторы предложили не требующий дополнительного обучения метод: способная рассуждать мультимодальная модель (работающая с текстом и изображениями) итеративно ищет и анализирует информацию в Википедии, собирая доказательства по ходу рассуждения. Контролируемые эксперименты показали, что рассуждение и поиск по отдельности работают слабо: само по себе рассуждение почти не повышает точность на редких сущностях, а поиск без рассуждения улучшает результат на редких сущностях, но может ухудшить общую точность. Лучший результат даёт именно сочетание того и другого.
Метод проверили на MERLIN, многоязычном мультимодальном бенчмарке для связывания сущностей, охватывающем пять языков: хинди, индонезийский, японский, тамильский и вьетнамский. Лучшая конфигурация авторов превзошла прежний лучший результат на 6,9% в среднем по всем сущностям и до 23,3% на срезах с редкими сущностями. Вместе с методом авторы выпустили MERLIN-Rare, набор тестовых срезов именно с редкими сущностями для прицельной проверки таких систем.
Ключевые факты
- Системы мультимодального связывания сущностей теряют 15,4, 39,9% точности на редких сущностях, которые выявляют структурные метрики графа знаний (а не только метрики популярности вроде просмотров страницы)
- Предложенный метод не требует дообучения: рассуждающая мультимодальная модель итеративно ищет и анализирует материал в Википедии, собирая доказательства по ходу работы
- Рассуждение само по себе почти не помогает на редких сущностях, поиск сам по себе помогает на редких сущностях, но может снижать общую точность, лучший результат даёт только их сочетание
- На бенчмарке MERLIN (пять языков: хинди, индонезийский, японский, тамильский, вьетнамский) лучшая система превзошла прежний лучший результат на 6,9% в среднем и до 23,3% на срезах с редкими сущностями
- Вместе с методом выпущен набор MERLIN-Rare, тестовые срезы именно с редкими сущностями для отдельной проверки таких систем
Почему это важно
Системы, которые связывают упоминания в тексте и на изображениях с записями в базе знаний, обычно неплохо работают на известных, хорошо задокументированных сущностях, но резко теряют точность на редких, до сих пор редкость измеряли в основном по популярности (просмотрам страницы). Авторы показывают, что структурные метрики графа знаний находят много редких сущностей, которые метрики популярности пропускают, и именно на них падение точности достигает 15,4, 39,9%. Это меняет саму постановку задачи: без верной оценки редкости часть провалов системы просто не видна в стандартных тестах.
Кому это важно
Разработчикам поисковых и справочных систем, мультимодальных ассистентов и систем на основе баз знаний, которые работают не только с английским языком и не только с самыми известными сущностями, компаниями, персонами, местами. Особенно тем, кто строит такие системы для языков из выборки MERLIN (хинди, индонезийский, японский, тамильский, вьетнамский) или для похожих языков с ограниченным покрытием в источниках вроде Википедии.
Как это применить
Метод не требует дообучения модели, это надстройка поверх уже существующей способной рассуждать мультимодальной модели, которая в несколько шагов ищет и анализирует информацию в Википедии. Это делает его применимым к готовым моделям без затрат на переобучение, но, по данным статьи, отдача есть только при сочетании поиска и рассуждения: одно лишь добавление рассуждений без поиска пользы почти не даёт, а поиск без рассуждений может даже снизить общую точность.
Можно ли доверять
Результаты получены в контролируемых экспериментах, которые отдельно проверяют вклад рассуждения и вклад поиска, это позволяет увидеть, что работает, а что нет, а не просто предъявить суммарный прирост. Авторы также выпускают MERLIN-Rare, набор тестовых срезов с редкими сущностями, что даёт возможность независимо проверить заявленные цифры. В самом тексте не указаны имена всех авторов, их организации, конкретная модель, использованная в фреймворке, размер датасета MERLIN и место или дата публикации работы.
Риски и подводные камни
В открытом тексте не раскрыты вычислительные затраты и число шагов поиска и рассуждения, которые выполняет метод, а итеративный процесс с обращением к внешнему источнику обычно медленнее и дороже одного прохода модели. Также не указано, какая именно модель использовалась и какого она размера, не назван размер датасета и не уточнены пороги, по которым сущности отнесены к редким. Все приведённые цифры, относительные проценты улучшения к прежнему лучшему результату, а не абсолютные показатели точности, что затрудняет прямое сравнение с другими подходами.