Исследование: в нейросетях для решений последние шесть слоёв можно убрать без потерь
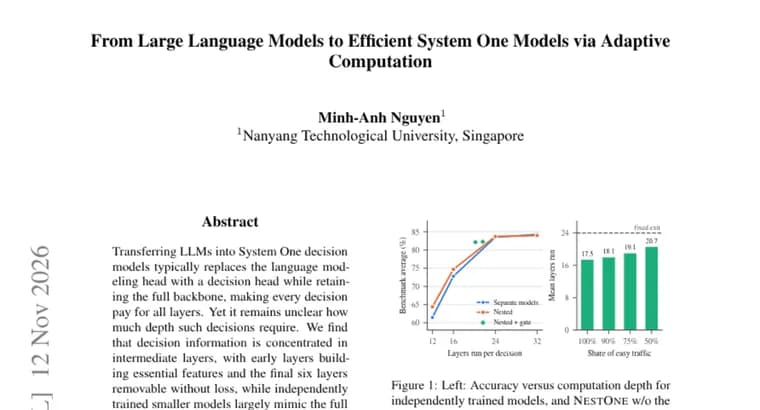
Статья из каталога Hugging Face Papers посвящена тому, сколько слоёв реально нужно большой языковой модели (LLM), когда её превращают в модель принятия решений типа System One. По описанию авторов, обычно при таком переносе голову языкового моделирования заменяют на «голову решения», а всю основную сеть (backbone) оставляют целиком, поэтому каждое решение оплачивается вычислениями по всем слоям. При этом неясно, сколько глубины такие решения вообще требуют.
Авторы сообщают, что информация, нужная для решения, сосредоточена в промежуточных слоях: ранние слои строят базовые признаки, а последние шесть слоёв основной сети можно убрать без потерь. Ещё одно наблюдение: отдельно обученные уменьшенные модели в основном копируют поведение полной модели, а не вырабатывают собственные специализированные способности к принятию решений. Из этого авторы делают вывод: эффективность достигается не простым уменьшением основной сети, а общими вычислениями на разных глубинах.
На этой основе предложен метод (его название в тексте аннотации отсутствует). Он совместно обучает полную модель и префиксные подмодели, то есть сети из первых слоёв, которые делят с полной моделью её последние слои и голову решения; обучение идёт через самодистилляцию. Кроме того, добавлен лёгкий «затвор» (gate): на каждом выходе он читает скрытое состояние и определяет, нужны ли дополнительные вычисления. Благодаря этому одна модель может работать на разном числе слоёв.
По заявлению авторов, на семи тестах принятия решений подход не хуже или лучше независимо обученных моделей на каждой глубине и даёт более выгодный баланс между точностью и затратами за счёт адаптивных вычислений. Конкретных чисел точности или ускорения в аннотации нет.
Ключевые факты
- Обычный перенос LLM в модели принятия решений System One заменяет голову языкового моделирования на голову решения, но оставляет все слои, поэтому каждое решение оплачивает полную глубину.
- Авторы находят, что информация о решении сосредоточена в промежуточных слоях, а последние шесть слоёв основной сети можно убрать без потерь.
- Независимо обученные малые модели в основном копируют полную модель, а не развивают специализированные навыки принятия решений.
- Предложенный метод совместно обучает полную модель и префиксные подмодели с общими последними слоями и общей головой решения через самодистилляцию; лёгкий затвор на каждом выходе решает, считать ли дальше.
- На семи тестах принятия решений подход, по заявлению авторов, не уступает независимо обученным моделям на каждой глубине и лучше балансирует точность и затраты.
Почему это важно
Если решение принимает модель на базе LLM, платить за все слои на каждом шаге расточительно. Работа утверждает, что часть глубины здесь лишняя: последние шесть слоёв основной сети можно убрать без потерь. Главный тезис авторов: эффективность даёт не просто уменьшение модели, а общие вычисления на разных глубинах и адаптивный выбор, сколько слоёв использовать.
Кому это важно
Прежде всего исследователям и инженерам, которые переделывают языковые модели в быстрые модели принятия решений типа System One и хотят снизить затраты на каждое решение. Также тем, кто изучает ранние выходы и адаптивные вычисления в нейросетях.
Как это применить
Практическая идея из описания: обучать полную модель вместе с префиксными подмоделями, которые делят последние слои и голову решения, и добавить лёгкий затвор, решающий на каждом выходе, нужно ли считать дальше. В тексте аннотации не упомянуты ни код, ни модели, ни данные, поэтому воспроизводить подход придётся по полному тексту статьи.
Можно ли доверять
Это препринт, и все утверждения принадлежат самим авторам: «без потерь», «не хуже или лучше» на семи тестах. В тексте аннотации нет численных результатов, названий тестов и сведений о том, какие модели и какого размера использовались, поэтому масштаб выигрыша проверить по нему нельзя. Авторы и организации в тексте не названы.
Риски и подводные камни
Вывод про шесть последних слоёв привязан к конкретной основной сети и конкретным задачам; в аннотации не сказано, какую долю модели это составляет и какие именно задачи решались, поэтому переносить цифру на другие модели нельзя. Результат заявлен для семи тестов принятия решений, и общность за их пределами не показана. Название метода в тексте отсутствует, а затвор добавляет собственную логику выбора глубины, которую нужно настраивать и проверять.