Исследование: в агентах для кода важнее всего управление контекстом
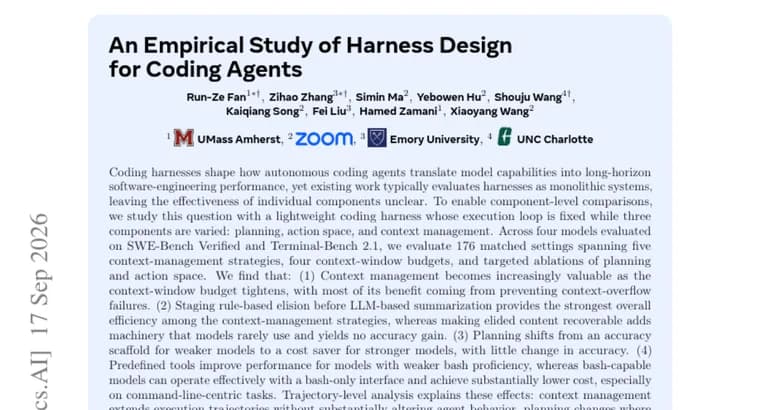
Обычно агентную обвязку (harness), программную оболочку, которая даёт модели цикл действий, набор инструментов и способ хранить историю диалога, оценивают целиком, как единую систему. Авторы исследования решили разобрать её на части и проверить вклад каждой по отдельности: зафиксировали общий цикл выполнения задачи и варьировали только три компонента, планирование, пространство действий (набор доступных агенту инструментов и команд) и управление контекстом. Эксперименты прогнали на четырёх моделях на двух бенчмарках, SWE-Bench Verified и Terminal-Bench 2.1, и получили 176 сочетаний настроек: пять разных стратегий управления контекстом, четыре разных бюджета контекстного окна и отдельные прогоны с отключённым планированием и урезанным пространством действий.
Получили четыре вывода. Во-первых, чем туже бюджет контекстного окна, тем больше пользы приносит управление контекстом, и почти весь этот выигрыш, не рост точности, а предотвращение сбоев из-за переполнения контекста. Во-вторых, среди пяти стратегий управления контекстом лучше всего по эффективности сработало сочетание: сначала убрать часть истории по жёстким правилам, а затем то, что осталось, сжать с помощью самой модели; при этом возможность позже восстановить удалённые фрагменты почти не используется моделями на практике и не даёт прироста точности, это просто лишняя сложность. В-третьих, планирование ведёт себя по-разному в зависимости от силы модели: для более слабых моделей оно работает как опора, поддерживающая точность, а для более сильных превращается скорее в способ снизить стоимость запуска, почти не меняя саму точность. В-четвёртых, заранее заданные инструменты помогают моделям, которые слабо владеют командной строкой (bash), а модели, уверенно работающие с bash, справляются интерфейсом «только bash» ничуть не хуже и при этом обходятся заметно дешевле, особенно на задачах, завязанных на командную строку.
Объяснение авторы строят на анализе траекторий выполнения задач: управление контекстом удлиняет траекторию, но заметно не меняет поведение агента; планирование меняет момент, в который агент останавливается; а пространство действий влияет на то, насколько крупными кусками агент пишет код. По словам авторов, эти находки помогают проектировать агентную обвязку с оглядкой на конкретную модель и бюджет контекста и дают модульный каркас для проверки будущих компонентов обвязки.
Ключевые факты
- Учёные проверили 176 сочетаний настроек агентной обвязки для кода на четырёх моделях на бенчмарках SWE-Bench Verified и Terminal-Bench 2.1.
- Управление контекстом тем ценнее, чем туже бюджет контекстного окна, и работает в основном за счёт предотвращения переполнения контекста, а не роста точности.
- Из пяти стратегий управления контекстом лучшую эффективность дало сочетание: сначала удаление части истории по правилам, затем сжатие моделью; возможность восстановить удалённое почти не используется и точности не добавляет.
- Планирование поддерживает точность у слабых моделей, а у сильных моделей становится скорее способом сэкономить, почти не меняя точность.
- Заранее заданные инструменты выгодны моделям со слабым владением командной строкой; модели, уверенно работающие с bash, справляются интерфейсом «только bash» и обходятся заметно дешевле, особенно на задачах командной строки.
Почему это важно
Разработчики агентных систем для кода обычно меняют обвязку целиком и смотрят на итоговый результат, не понимая, какой из компонентов, планирование, набор инструментов или управление контекстом, на самом деле дал эффект. Это исследование первым системно развело эти компоненты и проверило вклад каждого по отдельности на 176 сочетаниях настроек, а не на паре примеров.
Кому это важно
Тем, кто строит или настраивает агентов для написания и правки кода: разработчикам агентных фреймворков, командам, встраивающим ИИ-агентов в CI/CD и инженерные процессы, и исследователям, изучающим, как модели ведут себя на длинных многошаговых задачах.
Как это применить
Если бюджет контекстного окна ограничен, в первую очередь вкладываться в управление контекстом, а не в планирование или богатый набор инструментов: именно оно чаще всего спасает от срыва задачи из-за переполнения. Из стратегий управления контекстом предпочтительна связка «удаление по правилам, затем сжатие моделью» без сложной механики восстановления удалённого, она не окупается. Для менее способных моделей стоит добавлять планирование и заранее заданные инструменты; для сильных моделей, уверенно работающих с командной строкой, достаточно простого интерфейса «только bash», это дешевле, особенно на задачах, завязанных на командную строку.
Можно ли доверять
Методология описана подробно: фиксированный цикл выполнения, контролируемое варьирование трёх компонентов, 176 сочетаний настроек, четыре модели, два признанных в индустрии бенчмарка (SWE-Bench Verified и Terminal-Bench 2.1). В доступном тексте исследования нет конкретных числовых показателей точности по каждой модели, стратегии и бюджету, это ограничивает возможность независимо оценить масштаб описанных эффектов.
Риски и подводные камни
Выводы получены на четырёх конкретных моделях и двух конкретных бенчмарках, ориентированных на инженерные задачи; насколько они переносятся на другие семейства моделей, другие языки программирования или задачи вне бенчмарков, не проверялось. Авторская абстракция не называет исследовательский коллектив и организацию, так что независимо оценить репутацию и предыдущий опыт команды по одному только тексту нельзя.