Исследование: плотные награды уступают GRPO при равных вычислениях
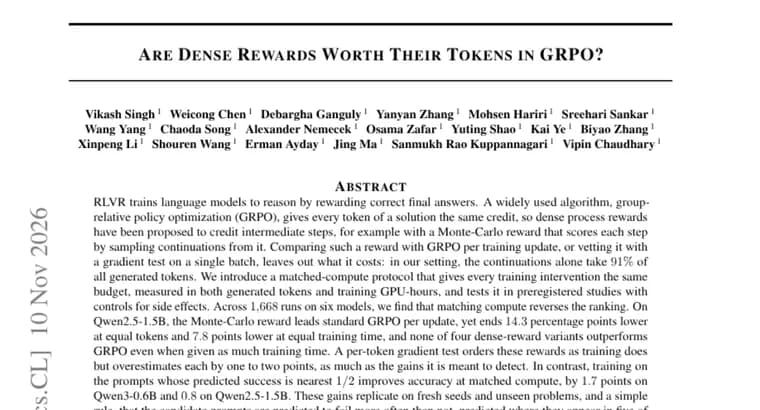
Авторы препринта (страница на Hugging Face содержит только аннотацию) разбирают обучение с подкреплением с проверяемыми наградами (RLVR): языковую модель учат рассуждать, поощряя правильный итоговый ответ. Популярный алгоритм GRPO (group-relative policy optimization) даёт каждому токену решения одинаковый «кредит», поэтому предлагались плотные процессные награды, оценивающие промежуточные шаги. Один из примеров, награда по методу Монте-Карло: каждый шаг оценивается по продолжениям, которые модель сэмплирует от этого шага.
По мнению авторов, такие награды обычно сравнивают с GRPO по числу обновлений обучения или проверяют градиентным тестом на одном батче, и при этом упускают их стоимость: в их постановке одни только продолжения занимают 91% всех сгенерированных токенов. Поэтому они вводят протокол равных вычислений (matched-compute): каждому вмешательству в обучение даётся одинаковый бюджет, измеряемый в сгенерированных токенах и GPU-часах обучения. Протокол проверяется в заранее зарегистрированных (preregistered) исследованиях с контролем побочных эффектов.
В сумме выполнено 1668 запусков на шести моделях, и выравнивание вычислений переворачивает рейтинг. На Qwen2.5-1.5B награда Монте-Карло опережает стандартный GRPO в пересчёте на одно обновление, но заканчивает обучение на 14,3 процентного пункта ниже при равном числе токенов и на 7,8 пункта ниже при равном времени обучения. Ни один из четырёх вариантов плотной награды не превзошёл GRPO даже при таком же времени обучения. Градиентный тест по отдельным токенам упорядочивает награды так же, как реальное обучение, но завышает каждую на один, два пункта, столько же, сколько составляют выигрыши, которые он должен выявлять.
В противовес этому обучение на промптах, для которых предсказанная вероятность успеха ближе всего к 1/2, повышает точность при равных вычислениях: на 1,7 пункта на Qwen3-0.6B и на 0,8 пункта на Qwen2.5-1.5B. Эти выигрыши воспроизводятся на новых сидах и на невиданных задачах. Простое правило, кандидаты в промпты предсказаны как чаще проваливаемые, чем решаемые, верно предсказало, где выигрыш проявится, в пяти из шести предрегистрированных тестов. Оба выигрыша приходят рано в обучении, а стандартный GRPO с удвоенной начальной скоростью обучения оказывается в пределах половины пункта от них.
Итог авторов: вмешательства в обучение стоит проверять при равных вычислениях, это опровергает одни кажущиеся улучшения и подтверждает другие.
Ключевые факты
- Протокол равных вычислений даёт каждому вмешательству в RLVR одинаковый бюджет в сгенерированных токенах и GPU-часах; проверка, 1668 запусков на шести моделях в предрегистрированных исследованиях.
- На Qwen2.5-1.5B награда Монте-Карло лидирует по обновлениям, но к концу на 14,3 п.п. ниже GRPO при равных токенах и на 7,8 пункта ниже при равном времени обучения; продолжения занимают 91% токенов в постановке авторов.
- Ни один из четырёх вариантов плотной награды не обошёл GRPO даже при равном времени обучения.
- Обучение на промптах с предсказанным успехом около 1/2 даёт +1,7 пункта на Qwen3-0.6B и +0,8 на Qwen2.5-1.5B при равных вычислениях.
- GRPO с удвоенной начальной скоростью обучения оказывается в пределах половины пункта от этих выигрышей.
Почему это важно
Сравнение методов обучения по числу обновлений скрывает их реальную цену. Здесь плотная награда по методу Монте-Карло выглядит лучше GRPO на одно обновление, но при равных токенах и равном времени обучения оказывается хуже: в постановке авторов продолжения съедают 91% всех сгенерированных токенов. Работа показывает, что вывод о превосходстве метода может зависеть от того, как выравнивать бюджет.
Кому это важно
Исследователям и инженерам, которые обучают рассуждающие модели с проверяемыми наградами и выбирают между GRPO, процессными наградами и отбором промптов. Также рецензентам и авторам статей про обучение с подкреплением: аргумент касается способа сравнения методов.
Как это применить
Практический вывод авторов: сравнивать вмешательства в обучение при одинаковом числе сгенерированных токенов и GPU-часов, а не только по числу обновлений. Из конкретных приёмов, обучение на промптах с предсказанной вероятностью успеха около 1/2. Но стоит помнить, что стандартный GRPO с вдвое большей начальной скоростью обучения подходит к этим выигрышам на расстояние в половину пункта.
Можно ли доверять
Заявлены предрегистрированные исследования, контроль побочных эффектов и 1668 запусков; выигрыш от выбора промптов воспроизводится на новых сидах и невиданных задачах. С другой стороны, это препринт, а текст на странице, только аннотация: авторы и организации не названы, бенчмарк и состав шести моделей не указаны, разрывы 14,3 и 7,8 пункта приведены лишь для Qwen2.5-1.5B. Доля 91% относится к настройке авторов.
Риски и подводные камни
Результат по плотным наградам показан для конкретной постановки; 91% токенов на продолжения, оценка для неё, а не общее свойство награды Монте-Карло. Выигрыши от отбора промптов невелики (0,8-1,7 пункта), приходят рано в обучении и почти сводятся на нет простой настройкой скорости обучения. Градиентный тест ошибается на один, два пункта, то есть на величину самих искомых эффектов.
«Мы утверждаем, что вмешательства в обучение следует проверять при равных вычислениях: это опровергает одни кажущиеся улучшения и подтверждает другие.»
— Авторы статьи, аннотация