Исследование: мультимодальные нейросети без визуального энкодера могут догнать обычные с ростом масштаба
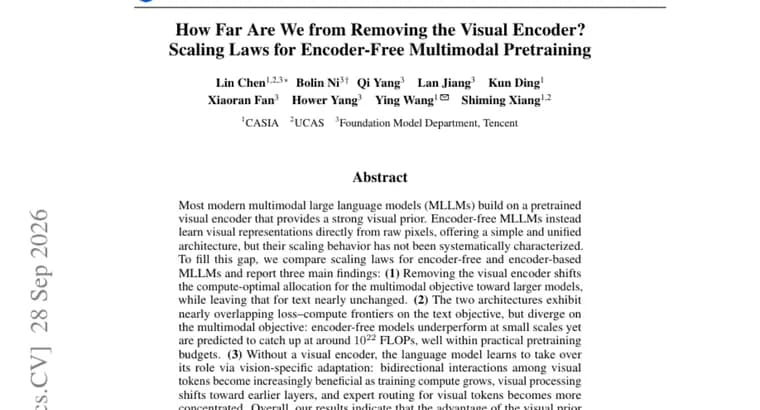
Большинство современных мультимодальных больших языковых моделей (MLLM) строятся на предобученном визуальном энкодере (кодировщике изображений), который даёт сильное визуальное предварительное знание. Альтернатива, MLLM без энкодера: они учатся представлениям изображений напрямую из сырых пикселей, что даёт простую и единую архитектуру. Но как такие модели ведут себя при росте масштаба, систематически не изучали.\n\nАвторы работы сравнили законы масштабирования моделей с энкодером и без него и сообщают о трёх главных выводах.\n\nПервый: если убрать визуальный энкодер, оптимальное по вычислениям распределение ресурсов для мультимодальной задачи смещается в сторону более крупных моделей, а для текстовой задачи почти не меняется.\n\nВторой: на текстовой задаче кривые «потери, вычисления» у двух архитектур почти совпадают, а на мультимодальной расходятся. Модели без энкодера на малых масштабах проигрывают, но, по прогнозу, догонят модели с энкодером примерно при 10^{22} FLOPs, по словам авторов, это вполне в пределах практических бюджетов предобучения. Это именно прогноз (экстраполяция), а не результат реального обучения.\n\nТретий: без визуального энкодера его роль берёт на себя сама языковая модель за счёт адаптации под зрение. Двусторонние взаимодействия между визуальными токенами становятся тем полезнее, чем больше вычислений затрачено на обучение; обработка изображения смещается в более ранние слои; маршрутизация экспертов для визуальных токенов становится более сосредоточенной.\n\nИтог, по словам авторов: преимущество визуального предварительного знания от предобученного энкодера с ростом масштаба уменьшается, а архитектуры без энкодера выглядят перспективным направлением для мультимодального предобучения.
Ключевые факты
- Сравнивались законы масштабирования мультимодальных LLM с предобученным визуальным энкодером и без него (обучение прямо на пикселях).
- Без энкодера оптимальное распределение вычислений для мультимодальной задачи смещается к более крупным моделям, для текста, почти не меняется.
- На тексте кривые «потери, вычисления» двух архитектур почти совпадают; на мультимодальной задаче модели без энкодера сначала уступают, но по прогнозу догонят примерно при 10^{22} FLOPs.
- Роль энкодера берёт на себя языковая модель: растёт польза двусторонних связей между визуальными токенами, обработка картинки уходит в ранние слои, маршрутизация экспертов концентрируется.
- Авторы делают вывод, что преимущество предобученного энкодера уменьшается с масштабом.
Почему это важно
Предобученный визуальный энкодер сегодня, стандартная часть мультимодальных моделей. Работа проверяет, нужен ли он при больших масштабах, и приходит к выводу, что его преимущество с ростом масштаба уменьшается. Если прогноз оправдается, архитектуры можно будет упрощать: одна единая модель, учащаяся на пикселях, вместо связки «энкодер плюс языковая модель».
Кому это важно
Командам, которые проектируют и предобучают мультимодальные модели и выбирают между готовым энкодером и единой архитектурой. Также исследователям законов масштабирования и архитектур со смесью экспертов, поскольку в работе описано, как меняется маршрутизация экспертов для визуальных токенов.
Как это применить
Прямых рекомендаций для практики в тексте нет. Из выводов следует ориентир: по прогнозу авторов, примерно при 10^{22} FLOPs модели без энкодера догоняют модели с энкодером на мультимодальной задаче, и это, по их оценке, укладывается в практические бюджеты предобучения. При меньших бюджетах модели без энкодера уступают.
Можно ли доверять
Пересказ основан на аннотации работы; в ней нет данных о размерах моделей, наборах данных и конкретных метриках, поэтому оценить силу результатов по тексту нельзя. Ключевой вывод о точке «догоняния» на 10^{22} FLOPs, прогноз по законам масштабирования, а не наблюдавшийся результат обучения. Утверждения принадлежат самим авторам работы.
Риски и подводные камни
Экстраполяция законов масштабирования может не оправдаться за пределами измеренных масштабов. Прогноз относится к мультимодальной задаче; на текстовой задаче различий между архитектурами почти нет. Кроме того, смещение оптимума к более крупным моделям означает иное распределение вычислений, но насколько крупнее, в аннотации не указано.